Questões de Concurso
Sobre conhecimentos de estatística em estatística
Foram encontradas 1.271 questões


Considerando as melhores práticas e os desafios da mineração de dados, analise as afirmativas a seguir.
I. Foram gerados insights a partir de dados válidos e confiáveis.
II. A equipe executora contava com especialistas com experiência em programação Python, R e SQL.
III. A metodologia empregada atendeu a literatura e outros estudos técnicos semelhantes, descrevendo que foi selecionada apenas uma base de informações de dados não estruturados atualizada para realizar o processamento, em virtude de limitações de capacidade computacional, dos custos envolvidos e dos testes que demonstraram a introdução de incerteza ao se realizar uma coleta ampla e profunda de conjuntos de dados.
Está correto o que se afirma em:
A matriz a seguir apresenta dois valores desconhecidos, A e B, que podem ser determinados por diferentes métodos de interpolação geoestatística.
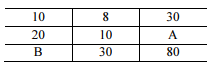
Com base nas informações apresentadas e considerando que a distância entre dois pontos adjacentes é igual a uma unidade, julgue o item subsequente.
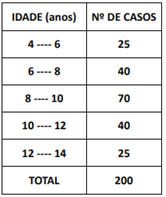
Considerando a distribuição de frequência que trata da incidência de mortes por violência, assinale com V o que for verdadeiro e com F o que for falso.
( ) A idade média é de 9 anos.
( ) A distribuição é assimétrica.
( ) A idade mediana é de 10 anos.
( ) A incidência de casos com crianças com idade inferior a 8 anos foi de 32,50%.
( ) A melhor representação gráfica para essa distribuição de frequência é o gráfico em pizza.
Está correta, de cima para baixo, a seguinte sequência:
[35, 42, 38, 40, 1500, 37, 39, 41, 36, 2500, 43, 5000, 38, 44, 3700]
Utilizando o Spark SQL, calcularam a média e o desvio padrão amostral das compras. Um valor é considerado anomalia se estiver acima de 2 desvios padrão da média.
Em relação à situação proposta e à análise, assinale a alternativa que apresenta as transações que podem ser classificadas como anômalas.
O texto a seguir é referência para a questão.
Em uma aplicação de análise fatorial, baseada na matriz de covariâncias, p = 4 variáveis (y1, y2, y3 e y4) foram reduzidas a m = 2 fatores comuns (F1 e F2). Adicionalmente, considere a solução com m = 2 fatores, e as seguintes matrizes de cargas fatoriais (L) e matriz diagonal de variâncias específicas ψ:
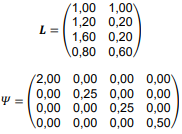
em que Lij representa a carga da variável i no fator j, e ψij é a variância específica de yi, i, j = 1, 2, 3, 4.
Com base nessa situação e nos princípios dos métodos de multicritério, é CORRETO afirmar que:
O gráfico de barras abaixo representa a distribuição das alturas (em metros) dos alunos de uma turma do ensino médio, agrupadas em intervalos de 0,05 m:
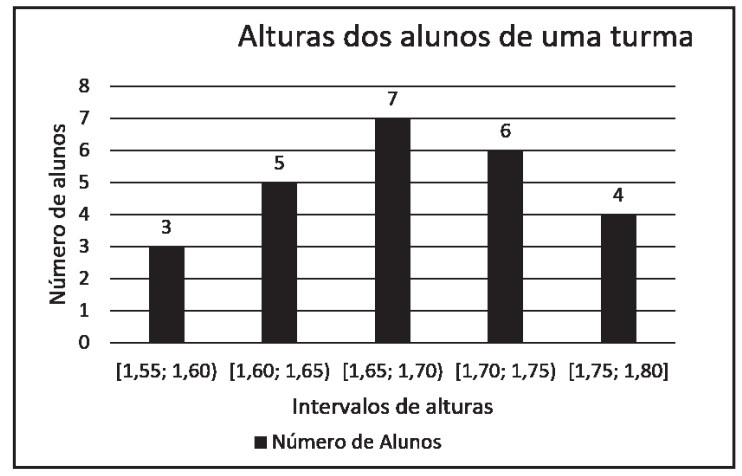
A média das alturas dos alunos dessa turma, com aproximação de duas casas decimais, é igual a
Considere a seguinte lista de números como população para R a s c unho responder à questão.
15, 19, 21, 10, 15, 22, 21, 21
(__) O uso de softwares de plotagem permite ajustes estatísticos, como regressão linear, reduzindo a necessidade de cálculos manuais.
(__) A definição de escalas e legendas em planilhas eletrônicas exige sempre edição manual, inviabilizando a automatização do processo.
(__) A identificação de pontos discrepantes é dificultada pela representação gráfica, sendo necessária análise estatística externa.
(__) A comparação de resultados experimentais com modelos teóricos torna-se mais rápida, pois a visualização imediata dos dados favorece conclusões embasadas.
A sequência está correta em:
Assinale a alternativa que apresenta uma métrica de desempenho de algoritmos classificadores.

Nessa situação hipotética, a média do processo é igual a
Acerca de técnicas utilizadas na ciência de dados, julgue o item a seguir.
A métrica lift é usada para medir a dependência entre dois itens em uma regra de associação: se o lift de uma regra de associação entre dois itens A e B for maior que 1, então A e B obrigatoriamente aparecerão em conjunto mais frequentemente do que seria esperado se A e B fossem independentes.
Um pesquisador está desenvolvendo um modelo estatístico para descrever a ocorrência de falhas em sensores em uma rede de equipamentos agrícolas. Com base em dados históricos, que incluem registros de falhas e fatores associados, tais como temperatura, umidade e frequência de transmissão dos sensores, o pesquisador obteve as seguintes informações:
• a probabilidade de um sensor falhar (F) em condições de alta umidade (U) é P(F | U) = 0,4;
• a incidência de eventos de alta umidade é dada pela probabilidade P(U) = 0,3;
• a probabilidade de um sensor falhar em condições de alta temperatura (T) é P(F | T) = 0,2;
• a incidência de falhas é P(F) = 0,2.
Com respeito a essa situação hipotética, e tendo em conta ainda que 0 < P(T) < 1, julgue o item subsequente.
Se  denota o evento complementar de U, então
 = 0,6.
Um pesquisador está desenvolvendo um modelo estatístico para descrever a ocorrência de falhas em sensores em uma rede de equipamentos agrícolas. Com base em dados históricos, que incluem registros de falhas e fatores associados, tais como temperatura, umidade e frequência de transmissão dos sensores, o pesquisador obteve as seguintes informações:
• a probabilidade de um sensor falhar (F) em condições de alta umidade (U) é P(F | U) = 0,4;
• a incidência de eventos de alta umidade é dada pela probabilidade P(U) = 0,3;
• a probabilidade de um sensor falhar em condições de alta temperatura (T) é P(F | T) = 0,2;
• a incidência de falhas é P(F) = 0,2.
Com respeito a essa situação hipotética, e tendo em conta ainda que 0 < P(T) < 1, julgue o item subsequente.
Os eventos F e T são independentes.
A respeito de máquinas de vetores de suporte e de avaliação de modelos de regressão, julgue o próximo item.
MSE (mean squared error) é uma medida usada para a avaliação da acurácia de modelos de classificação e representa a métrica de fidelidade de acerto de um modelo em relação ao atributo alvo (target attributes), portanto, pode ser utilizada para avaliar o desempenho de assertividade do modelo.

 Conheça nossos planos