Questões de Concurso
Sobre data mining em banco de dados
Foram encontradas 581 questões


Julgue o próximo item, a respeito de machine leaning.
Árvores de decisão são técnicas de modelagem preditiva que particionam iterativamente os dados em subconjuntos homogêneos baseados em variáveis explicativas.
Julgue o próximo item, a respeito de machine leaning.
Os algoritmos de regressão linear, por minimizarem a soma dos resíduos quadrados para ajustar os coeficientes, são sensíveis a outliers, que podem distorcer os coeficientes e comprometer a previsão do modelo.
Julgue o próximo item, a respeito de machine leaning.
Grandes volumes de dados frequentemente revelam padrões e tendências que são valiosos para análises preditivas e tomadas de decisão, facilitando a antecipação de comportamentos futuros e permitindo melhor alocação de recursos e planejamento.
( ) K-means, também conhecido como K-NN, é um algoritmo baseado na ideia de que objetos semelhantes estão próximos uns dos outros.
( )Árvore de decisão é uma estrutura hierárquica constituída por nós. Nela, o coeficiente de Gini de um nó é sempre maior do que o do seu nó pai.
( ) O algoritmo SVM, utilizado apenas para a tarefa de classificação, emprega classificadores lineares que separam o conjunto de dados por meio de hiperplanos, não sendo possível seu uso com problemas não linearmente separáveis.
As afirmativas são, respectivamente,
( ) Uma árvore de decisão é um grafo cíclico direcionado em que cada nó é um nó de divisão.
( ) Em uma rede neural artificial multicamadas os neurônios estão conectados a todos os neurônios da camada anterior.
( ) As máquinas de vetores de suporte (SVM - Support Vector Machine) são aplicadas em problemas de classificação nos quais busca-se dividir os dados por meio de um hiperplano.
As afirmativas são, respectivamente,
A respeito de data mart e data mining, julgue o item a seguir.
O uso de data mining permite, por exemplo, que uma empresa de varejo descubra padrões de compra ocultos em grandes volumes de dados, permitindo que a empresa crie promoções direcionadas ou ajuste o leiaute da loja para aumentar as vendas.
Acerca de data mining e data mart, julgue o item subsequente.
A técnica de clustering (agrupamento), em data mining, é utilizada para classificar dados em categorias predefinidas, facilitando a análise de grandes volumes de dados.
Em relação às fases do CRISP-DM, julgue o próximo item.
A fase 7 do CRISP-DM indica que o processo de construção do armazém de dados correspondente deve ser revisado em função das atualizações dos dados.
Em relação às fases do CRISP-DM, julgue o próximo item.
Na fase de modelagem do CRISP-DM, além da divisão de dados em treinamento, testes e validação, são escolhidos os algoritmos que podem ser testados e utilizados de acordo com o tipo de exploração dos dados desejada.
I – As soluções para resolver o problema de valores ausentes são diversas, sendo as mais comuns: remoção do exemplar em que ocorre a falta do valor, preenchimento manual dos valores e preenchimento automático dos valores.
II – Os valores ruidosos referem-se a modificações dos valores originais e que, portanto, consistem em erros de medidas ou em valores consideravelmente diferentes da maioria dos outros valores do conjunto de dados, os chamados outliers. Há duas abordagens para o tratamento destes dados: inspeção e correção manual; e identificação e limpeza automática.
III - Procedimentos para integração de dados consistem em realizar ações que permitam integrar, adequadamente, dados provenientes de diversas fontes de dados. Geralmente, quando os dados provêm de diferentes fontes, os valores assumidos por atributos não possuem o mesmo domínio ou não estão formatados sob o mesmo tipo de dado, ainda que digam respeito à mesma descrição de uma entidade do mundo real. As principais motivações para a aplicação de procedimentos de integração de dados são, portanto, a presença de valores inconsistentes e a presença de valores redundantes.
De acordo com Silva, Peres e Boscarioli (2016), é CORRETO afirmar que:
I – A mineração de dados é uma disciplina exclusiva da engenharia da computação, utilizada como ferramenta por demais áreas de conhecimento.
II – As tarefas descritivas da mineração de dados fazem inferência a partir dos dados e possuem o objetivo de realizar predições.
III – Durante as tarefas de mineração de dados, os valores de dados outliers não podem ser descartados, para garantir a fidedignidade do modelo em uso.
Conforme Castro e Ferrari (2016), é CORRETO afirmar que:
I – As aplicações de OLAP são dominadas por consultas ad hoc complexas. Em termos de SQL (Structured Query Language), as consultas OLAP envolvem operadores de agrupamento e agregação e fornecem excelente suporte para condições booleanas complexas.
II – O problema fundamental na manutenção de um Data Warehouse é a manutenção síncrona de tabelas replicadas e visões materializadas.
III – A mineração de dados está relacionada à subárea da estatística chamada análise combinatória de dados.
RAGHU, R.; GEHRKE, J., Sistemas de Gerenciamento de Banco de Dados, 3° Ed. Editora McGraw-Hill, 2011.
Assinale a alternativa correta conforme Raghu e Gehrke (2011):
Avalie a tabela apresentada em Silva, Peres e Boscarioli (2017, p. 48) e responda a questão.
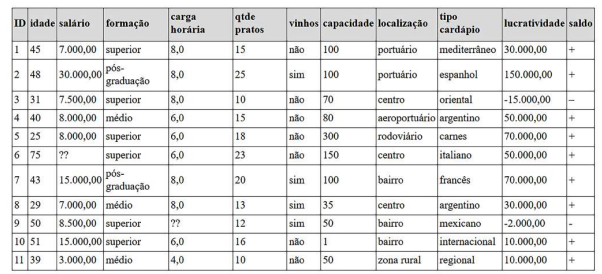
(SILVA, Leandro Augusto da; PERES, Sarajane Marques; BOSCARIOLI, Clodis. Introdução à Mineração de Dados Com Aplicações em R. Rio de Janeiro: Elsevier, 2016.)
A avalie as seguintes sentenças
I - Se a mineração de dados for executada com algoritmos que aceitam apenas dados categóricos, poderse-á aplicar alguma técnica de categorização para conversão de dados. Por exemplo, converter “idade” em “jovem” (para idades de 18 até 49 anos) ou “sênior” (para idades de 50 a 90 anos).
II - Se a mineração de dados for executada com algoritmos que aceitem apenas dados numéricos, poder-se-á aplicar alguma técnica de discretização para conversão de dados. Por exemplo, converter “formação” de “nenhuma” para 1, “fundamental” em 2, “médio” em 3, “superior” em 4, “pós-graduação” em 5.
III - Se a mineração de dados for executada com algoritmos que aceitem somente um determinado tipo de dados, deve-se obter outro conjunto de dados.
De acordo com Silva, Peres e Boscarioli (2016), é VERDADEIRO o que se afirma:
Avalie a tabela apresentada em Silva, Peres e Boscarioli (2017, p. 48) e responda a questão.
(SILVA, Leandro Augusto da; PERES, Sarajane Marques; BOSCARIOLI, Clodis. Introdução à Mineração de Dados Com Aplicações em R. Rio de Janeiro: Elsevier, 2016.)
Considere as sentenças relacionadas às tarefas de mineração de dados.
I - As tarefas preditivas usam os valores dos atributos descritivos para prever valores futuros ou incógnitos de outros atributos de interesse.
II - As tarefas consultivas usam valores dos atributos para identificar modelos que podem ser utilizados na classificação e reconhecimento de padrões.
III - As tarefas descritivas têm o objetivo de reconhecer padrões que descrevem os dados de maneira que o ser humano possa interpretar.
IV - As tarefas imperativas são implementadas com linguagens de programação baseadas em paradigmas imperativos.
De acordo com Silva, Peres e Boscarioli (2016), é VERDADEIRO o que se afirma:
(SILVA, Leandro Augusto da; PERES, Sarajane Marques; BOSCARIOLI, Clodis. Introdução à Mineração de Dados Com Aplicações em R. Rio de Janeiro: Elsevier, 2016.)
I. Seu objetivo é extrair conjuntos de itens frequentes de um banco de dados.
II. Um exemplo de padrão frequente são as regras de associação.
III. Dado um conjunto de itens X = {x1, x2,…,xm} e um conjunto de transações T = {t1, t2, …, tn}, um subconjunto de X, S, é chamado de conjunto de itens frequentes se S ocorre em uma porcentagem de todas as transações em T que excede um limite, denominado suporte.
IV. O suporte de um conjunto de itens Y, suporte(Y), é definido como o número de transações em T que contêm o conjunto de itens Y.
Das afirmativas acima, é correto afirmar que:

 Conheça nossos planos