Questões de Concurso
Sobre data mining em banco de dados
Foram encontradas 581 questões


Ano: 2026
Banca:
CESPE / CEBRASPE
Órgão:
TCE-RN
Prova:
CESPE / CEBRASPE - 2026 - TCE-RN - Analista Administrativo - Especialidade: Tecnologia da Informação |
Q4014204
Banco de Dados
Texto associado
Acerca de técnicas para pré-processamento de dados,
CRISP-DM, análise de grupamento, detecção de anomalias e
regras de associação, julgue o próximo item.
No contexto de regras de associação, o conceito de confiança
refere-se à expectativa de que um dado, grupo ou banco de
dados atue da maneira esperada em dada situação.
Q4013973
Banco de Dados
No ciclo de vida CRISP-DM (Cross-Industry
Standard Process for Data Mining), usado em
Ciência de Dados, qual etapa trata da limpeza,
tratamento e formatação dos dados:
Q4013972
Banco de Dados
A ciência de dados utiliza métodos e
técnicas com o objetivo de extrair conhecimento
e insights a partir de grandes volumes de dados.
A análise de dados inicia-se com uma pergunta
que pode ser classificada em diversos tipos. O
tipo de pergunta que busca identificar se existem
padrões, tendências ou relacionamentos em um
conjunto de dados, sem a necessidade de uma
hipótese prévia, é classificada como:
Q4009191
Banco de Dados
No contexto da Ciência de Dados, o conceito que está
diretamente relacionado ao estabelecimento de
políticas, processos, papéis e responsabilidades para
garantir qualidade, segurança, conformidade e uso
adequado dos dados ao longo de seu ciclo de vida é
Q3968381
Banco de Dados
No processo de descoberta de conhecimento (KDD), a etapa de mineração de dados se caracteriza por
Ano: 2026
Banca:
FCC
Órgão:
SEFAZ-SP
Prova:
FCC - 2026 - SEFAZ-SP - Auditor Fiscal da Receita Estadual - AFRE - Gestão Tributária - Conhecimentos Específicos (P3) |
Q3956761
Banco de Dados
No desenvolvimento de um modelo de detecção de contribuintes com alto risco de simulação de operações, após definir claramente com a área de fiscalização quais tipos de fraude serão priorizados, quais indicadores de negócio serão acompanhados
(como aumento de autos de infração qualificados e redução de fiscalizações improdutivas) e quais restrições legais e
operacionais existem para uso do modelo, a equipe de uma Secretaria da Fazenda registra esses critérios e alinha expectativas
com a alta gestão. Com base na metodologia CRISP-DM, essa descrição se encaixa principalmente na fase de
Ano: 2026
Banca:
FADESP
Órgão:
SEFAZ-PA
Prova:
FADESP - 2026 - SEFAZ-PA - Fiscal de Receitas Estaduais - Conhecimentos Gerais |
Q3951157
Banco de Dados
Ao executar o algoritmo Apriori, as seguintes regras associativas foram determinadas como relevantes:
{café, açúcar} => {leite} e {açúcar, trigo} => {leite}.
Considerando essas duas regras associativas relevantes, é verdade que
{café, açúcar} => {leite} e {açúcar, trigo} => {leite}.
Considerando essas duas regras associativas relevantes, é verdade que
Ano: 2026
Banca:
FGV
Órgão:
AL-GO
Prova:
FGV - 2026 - AL-GO - Analista Legislativo - Analista de Ciência de Dados |
Q3880237
Banco de Dados
Matheus foi empossado recentemente pela ALEGO como analista
e está se aprofundando nos estudos das redes neurais (RN). Ele
sabe que as RN podem ter diversas formas de aprendizagem não
supervisionada.
O tipo de aprendizado onde os neurônios de saída da rede disputam entre si para se tornarem ativos e somente um neurônio de saída é ativado em determinado instante se denomina:
O tipo de aprendizado onde os neurônios de saída da rede disputam entre si para se tornarem ativos e somente um neurônio de saída é ativado em determinado instante se denomina:
Ano: 2026
Banca:
FGV
Órgão:
AL-GO
Prova:
FGV - 2026 - AL-GO - Analista Legislativo - Analista de Ciência de Dados |
Q3880236
Banco de Dados
O perceptron é um dos modelos de redes neurais artificiais mais
simples e tradicionais. A figura a seguir ilustra o grafo arquitetural
de um perceptron. Analise-a.
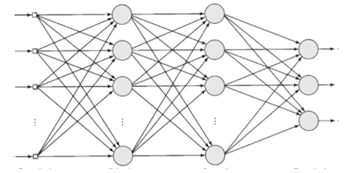
Com relação as características do grafo, analise as afirmativas a seguir.
I. A rede possui várias camadas, sendo quatro camadas ocultas e três camadas de saída de dados.
II. A rede é do tipo totalmente conectada, isso significa que cada neurônio em qualquer camada está conectado a todos os outros neurônios da camada anterior.
III. O fluxo de sinais é unidirecional e progride na rede da esquerda para a direita e de camada em camada.
Está correto o que se afirma em
Ano: 2026
Banca:
FGV
Órgão:
AL-GO
Prova:
FGV - 2026 - AL-GO - Analista Legislativo - Analista de Ciência de Dados |
Q3880235
Banco de Dados
Árvores de decisão (AD) são classificadores muito utilizados em
Ciência de Dados. Com relação as características da AD, analise as
afirmativas a seguir.
I. É a representação de uma função que mapeia um vetor de valores de atributos para um único valor de saída.
II. Uma árvore de decisão chega à sua decisão realizando uma sequência de testes, começando por uma de suas raízes e seguindo o ramo apropriado até que uma folha seja alcançada.
III. Cada nó interno na árvore corresponde a um teste do valor de um dos atributos de entrada, os ramos a partir do nó são rotulados com os possíveis valores do atributo, e os nós folha especificam qual valor deve ser retornado pela função.
Está correto o que se afirma em
Ano: 2026
Banca:
FGV
Órgão:
AL-GO
Prova:
FGV - 2026 - AL-GO - Analista Legislativo - Analista de Ciência de Dados |
Q3880232
Banco de Dados
A regressão logística é um modelo muito popular na ciência de
dados, ele é muito utilizado em diversos projetos da ALEGO. Com
relação às características da regressão logística, analise as
afirmativas a seguir.
I. É um modelo de regressão linear e dentro do contexto do aprendizado de máquina, a regressão logística pertence à família de modelos de aprendizado de máquina supervisionado.
II. Representa dois grupos de interesse como uma variável binária com valores 0 e 1, não importando qual o grupo é designado com os valores o versus 1, mas a designação de como dever ser observada interpretação dos coeficientes.
III. A função logística é representada pelas seguintes fórmulas:
a) Logit(pi) = 1/(1+ ln(-pi))
b) exp(pi/(1-pi)) = β_0 + β _1*X_1 + … + β _k*K_k.
onde:
logit(pi) é a variável dependente ou de resposta, e x é a variável independente.
Está correto o que se afirma em
Ano: 2026
Banca:
FGV
Órgão:
AL-GO
Prova:
FGV - 2026 - AL-GO - Analista Legislativo - Analista de Ciência de Dados |
Q3880223
Banco de Dados
Os analistas de Ciência de Dados da ALEGO reconhecem que a
abordagem tradicional de análise de dados envolve um ciclo
composto por diversas etapas e uma vez que tenham definidos
seus modelos preditivos, eles podem ser aplicados a novos
conjuntos de dados. A figura criada pelos analistas representa um
ciclo de análise preditiva e score de dados. Analise a figura e
relacione a numeração indicada nas etapas com as suas
respectivas operações.
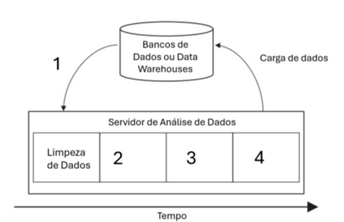
A relação correta, na ordem dada, é:
A relação correta, na ordem dada, é:
Ano: 2026
Banca:
FUNATEC
Órgão:
Prefeitura de São José do Divino - PI
Prova:
FUNATEC - 2026 - Prefeitura de São José do Divino - PI - Professor(a) - Ensino Fundamental Anos Finais - Informática |
Q3865193
Banco de Dados
O processo de KDD (Knowledge Discovery in
Databases) é fundamental na mineração de dados e
envolve etapas bem definidas.
Baseando-se nessas informações, pode-se concluir que a etapa do KDD responsável pela limpeza, seleção e transformação dos dados antes da aplicação dos algoritmos é denominada:
Baseando-se nessas informações, pode-se concluir que a etapa do KDD responsável pela limpeza, seleção e transformação dos dados antes da aplicação dos algoritmos é denominada:
Ano: 2026
Banca:
CESPE / CEBRASPE
Órgão:
TCE-MG
Prova:
CESPE / CEBRASPE - 2026 - TCE-MG - Analista de Controle Externo - Especialidade: Ciência da Computação |
Q3856625
Banco de Dados
Assinale a opção que apresenta a ferramenta de TI mais
apropriada para examinar grandes volumes de registros
financeiros e identificar inconsistências em uma auditoria de
políticas públicas e finanças.
Ano: 2026
Banca:
CESPE / CEBRASPE
Órgão:
TCE-MG
Prova:
CESPE / CEBRASPE - 2026 - TCE-MG - Analista de Controle Externo - Especialidade: Ciência da Computação |
Q3856600
Banco de Dados
Assinale a opção correta acerca do modelo LDA (latent dirichlet
allocation), amplamente utilizado para extração de tópicos em
tarefas de mineração de textos.
Q3851685
Banco de Dados
A análise de dados, no contexto da análise de negócios, envolve o
uso integrado de tecnologias computacionais, técnicas estatísticas
e métodos de ciência administrativa para transformar dados
históricos em informações úteis, apoiando decisões e
recomendando ações. Dentro desse escopo, a análise preditiva
busca responder “o que provavelmente acontecerá?”, recorrendo
a ferramentas capazes de identificar padrões e antecipar
comportamentos futuros a partir de grandes volumes de dados.
Considerando os facilitadores característicos da análise de negócios preditiva, assinale a opção que apresenta um facilitador típico dessa abordagem.
Considerando os facilitadores característicos da análise de negócios preditiva, assinale a opção que apresenta um facilitador típico dessa abordagem.
Ano: 2025
Banca:
IDCAP
Órgão:
PPSA
Prova:
IDCAP - 2025 - PPSA - Analista de Tecnologia da Informação - Infraestrutura de TI |
Q3841867
Banco de Dados
Atualmente, as empresas têm executado um processo
administrativo, denominado gestão de dados, que
consiste em recolher, organizar, proteger e usar
informações, com o objetivo de utilizar os dados para
melhorar a eficiência, a produtividade e a tomada de
decisões. Nesse contexto, um termo, que tem por
significado a mineração de dados, consiste no uso de
processos para explorar grandes quantidades de dados
digitais à procura de padrões consistentes, como regras
de associação ou sequências temporais, visando
descobrir relacionamentos sistemáticos entre variáveis,
detectando assim novos subconjuntos de dados.
Paralelamente, outro termo, traduzido como armazém de
dados, é, basicamente, um depósito de dados digitais
para armazenar informações corporativas detalhadas.
Esses dois termos são conhecidos, respectivamente, como:
Esses dois termos são conhecidos, respectivamente, como:
Ano: 2025
Banca:
Quadrix
Órgão:
Fundação do ABC
Provas:
Quadrix - 2025 - Fundação do ABC - Assistente Social - Edital nº 1
|
Quadrix - 2025 - Fundação do ABC - Enfermeiro - Edital nº 1 |
Quadrix - 2025 - Fundação do ABC - Farmacêutico - Edital nº 1 |
Quadrix - 2025 - Fundação do ABC - Médico Generalista - Edital nº 1 |
Q3756313
Banco de Dados
Texto associado
Texto para as questão.
O conhecimento tem sido reconhecido como um
dos mais importantes recursos de uma organização, que
torna possíveis ações inteligentes nos planos organizacional
e individual e leva a inovações e à capacidade de
continuamente criar produtos e serviços excelentes. O
processo de gestão do conhecimento abrange toda a forma
de gerar, armazenar, distribuir e utilizar o conhecimento, de
modo que se torna necessária a utilização de tecnologias
de informação para facilitar esse processo, dado o grande
aumento no volume de dados.
Ao longo do tempo, percebeu‑se que a velocidade
de coleta de informações era muito maior que a velocidade
de processamento ou de análise dessas informações.
Isso gerou um problema e uma contradição, pois as
organizações, por possuírem uma grande quantidade
de dados, possuem uma falsa sensação de que estão
bem‑informadas, no entanto essas informações de nada
servem se não forem analisadas de forma correta e em
tempo hábil.
Em outras palavras, a coleta e o armazenamento
de dados, por si sós, não contribuem para melhorar
a estratégia da organização. É necessário que sejam
feitas análises sobre essa grande quantidade de dados,
estabelecendo‑se indicadores para descobrir padrões de
comportamento implícitos nos dados, além de relações
de causa e efeito. O processamento e a análise das
informações geradas pelas enormes bases de dados atuais
de forma correta estão entre os requisitos essenciais para
uma boa tomada de decisão.
Em um ambiente tão mutável como o das
organizações, na atualidade, torna‑se necessária a aplicação
de técnicas e ferramentas automáticas que agilizem o
processo de extração de informações relevantes de grandes
volumes de dados. Uma metodologia emergente, que tenta
solucionar o problema da análise de grandes quantidades
de dados e ultrapassa a habilidade e a capacidade humanas,
é a descoberta de conhecimento em banco de dados.
Data mining, ou mineração de dados, é uma
técnica que faz parte de uma das etapas da descoberta de
conhecimento em banco de dados. Ela é capaz de revelar,
automaticamente, o conhecimento que está implícito em
grandes quantidades de informações armazenadas nos
bancos de dados de uma organização. Essa técnica pode
fazer, entre outras atividades, uma análise antecipada dos
eventos, prevendo tendências e comportamentos futuros
e permitindo aos gestores a tomada de decisões com base
em fatos, em vez de em suposições.
Internet: <scielo.br> (com adaptações).
Segundo o texto, a técnica de mineração de dados
Ano: 2025
Banca:
UFSM
Órgão:
UFSM
Prova:
UFSM - 2025 - UFSM - Analista de Tecnologia da Informação (Inteligência Artificial) |
Q3729822
Banco de Dados
Em uma pesquisa sobre hábitos daqueles que passaram no concurso público X, gerou-se a seguinte
tabela como exemplo dos dados coletados.
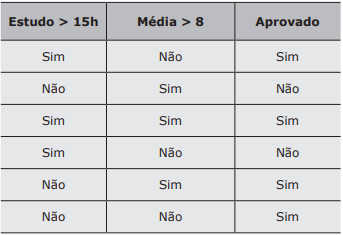
Hábitos vs Aprovação no Concurso X. A primeira coluna significa que o estudo semanal foi maior que 15h um mês antes do concurso. A segunda coluna refere-se à média final no curso superior. A coluna “Aprovado” refere-se a quem foi aprovado na primeira tentativa.
Para esta tabela, considerando a regra gerada pelo algoritmo Apriori, {Estudo>15h}→{Aprovado}, assinale a alternativa com a afirmação correta.
Ano: 2025
Banca:
UFSM
Órgão:
UFSM
Prova:
UFSM - 2025 - UFSM - Analista de Tecnologia da Informação (Inteligência Artificial) |
Q3729820
Banco de Dados
Há múltiplas maneiras de criar sistemas de recomendação. Uma das maneiras, baseada em mineração de dados, é identificar quais itens costumam
ocorrer em conjunto e posteriormente programá-las
no sistema. Tal problema é solucionado por algoritmos de associação que podem gerar regras ao estilo
setA→setB (leia-se, conjunto A implica conjunto B),
em que diversas métricas podem ser obtidas para
validar a força da regra.
Assinale a alternativa que, respectivamente, corresponde a um algoritmo de associação e a uma métrica usada para validar a regra.
Assinale a alternativa que, respectivamente, corresponde a um algoritmo de associação e a uma métrica usada para validar a regra.

 Conheça nossos planos