Questões de Concurso
Sobre estatística descritiva (análise exploratória de dados) em estatística
Foram encontradas 5.448 questões


Um analista está realizando análise exploratória de dados com a utilização de ferramentas de business intelligence por meio do Power BI. Ele deseja comparar a distribuição de uma variável numérica contínua entre diferentes categorias (por exemplo, despesas por órgão público), de forma que seja possível visualizar graficamente a mediana, os quartis, a amplitude interquartil e os valores atípicos (outliers).
Assinale a opção que corresponde ao gráfico do Power BI mais adequado para a finalidade pretendida pelo analista na situação hipotética apresentada.
• no experimento A, os resultados obtidos apresentaram valores muito próximos entre si, porém afastados do valor de referência certificado;
• no experimento B, os resultados apresentaram maior dispersão, mas a média obtida coincidiu com o valor de referência;
• em representações gráficas, o experimento A foi ilustrado por um alvo com dardos concentrados fora do centro e por uma curva de distribuição normal estreita deslocada do valor verdadeiro. Já o experimento B foi representado por dardos espalhados ao redor do centro e por uma curva normal mais larga, porém centrada no valor de referência.
Com base nos conceitos de exatidão e precisão, analise as assertivas e assinale a alternativa que aponta as corretas. I. O experimento A apresenta alta precisão e baixa exatidão. II. O experimento B apresenta alta exatidão e baixa precisão. III. Precisão está relacionada à proximidade entre os resultados obtidos e o valor verdadeiro. IV. Exatidão está relacionada à repetibilidade dos resultados obtidos em medições sucessivas. V. Uma curva normal mais estreita indica maior erro sistemático no método analítico.
De acordo com as informações consolidadas pelo Inmet na última segunda-feira de 2025, estas foram as temperaturas mais altas registradas no Brasil nesse dia:

A partir da análise dessa série estatística, verifica-se a existência de dois valores modais. Com base nessas informações, assinalar a alternativa que apresenta o valor absoluto da diferença entre esses valores modais.
S ← 0 ma ← 0
para rep = 1 até 100, incrementado rep a cada repetição
ma ← ma + amostra(rep)
fim do para
ma ← ma/100
para rep = 1 até 100, incrementado rep a cada repetição
S ← S + (amostra(rep) – ma)2
fim do para
S1 ← S/99 S2 ← S/100
Os valores de S1 e S2 obtidos pelo algoritmo acima a partir de 100 amostras são, respectivamente:
1. Variável aleatória X:
• 1º Momento Ordinário igual a 5;
• 2º Momento Ordinário igual a 1;
• 3º Momento Central igual a 2.
2. Variável aleatória Y:
• 1º Momento Ordinário igual a 2;
• 2º Momento Ordinário igual a 7;
• 3º Momento Central igual a 0.
3. Variável aleatória Z:
• 1º Momento Ordinário igual a 3;
• 2º Momento Ordinário igual a 9;
• 1º Momento Central igual a 0.
Com base exclusivamente nessas informações, assinale a afirmativa correta.

Considerando o valor obtido como uma variável aleatória, a diferença entre a média e a média amostral dos 100 valores é de
No que se refere à interpretação de relatórios estatísticos, assinale a afirmativa correta.

Com base nessa distribuição conjunta, a Var(X) e a Cov(X, Y) são, respectivamente,

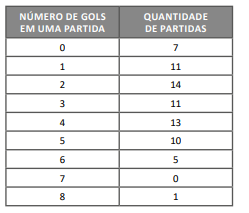
Com base na tabela, assinale a alternativa correta:

Assinale a opção que indica o critério de classificação que divide as feições em classes que possuem a mesma frequência de registros.
Para garantir a comparabilidade entre variáveis, ele aplicou a padronização por escore z (z-score) em um conjunto de dados multivariados, de modo que todas as variáveis passassem a apresentar média 0 e desvio-padrão 1.
Após a padronização, verificou-se que os dados não apresentavam forte separação entre grupos naturais. Em seguida, foi aplicado o algoritmo K-means em Python:
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
kmeans = KMeans(n_clusters=3, n_init=10, random_state=0)
kmeans.fit(X_scaled)
print(kmeans.cluster_centers_)
Observou-se que os centroides obtidos apresentam valores próximos de zero em todas as dimensões.
Considerando o contexto descrito, esse resultado ocorre porque


(https://censo2022.ibge.gov.br.)
Em relação ao perfil demográfico brasileiro, assinale a afirmativa INCORRETA.

 Conheça nossos planos