Questões de Concurso Sobre estatística
Foram encontradas 14.629 questões


Assinale a opção que apresenta a técnica mais apropriada para o estudo do pesquisador.
Considere o conjunto de dados a seguir, que apresenta, de forma simplificada, as características de uma amostra de 1600 animais de estimação.
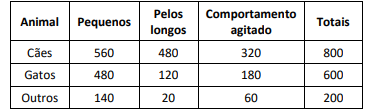
Sejam dois novos animais de estimação identificados por A e B, tais que:
• A é pequeno, com pelos curtos e de comportamento agitado;
• B é grande, com pelos longos e de comportamento agitado.
Aplicando o algoritmo Naïve Bayes, assinale a opção que apresenta as classes mais prováveis dos animais A e B, respectivamente.
Assinale a opção que indica o tipo de gráfico mais adequado para representar essa distribuição de frequência.
Considere o conjunto de dados e a informação a seguir:
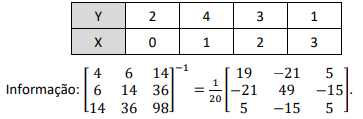
Deseja-se encontrar um modelo de regressão polinomial de 2º grau Y = a0 + a1 X + a2 X2 que melhor se encaixe nesse conjunto de dados.
Estimando-se pelo método dos mínimos quadrados, os valores de a0, a1 e a2 serão dados, respectivamente, por
Homens (H) |
Mulheres (M) |
Total |
|
Hospital Santa Casa (S) |
20 |
10 |
30 |
Hospital Geral (G) |
15 |
15 |
30 |
Hospital Central (C) |
40 |
5 |
45 |
Total |
75 |
30 |
105 |
Essa tabela apresenta dados referentes à distribuição de pacientes entre dois hospitais de uma cidade.
Considerando os dados da tabela, assinale a alternativa correta.
Em uma sala de aula, há 45 estudantes, sendo 20 meninos e 25 meninas. Seja X a variável aleatória que descreve o número de meninos em determinado grupo de estudantes. Caso sejam escolhidos 15 estudantes ao acaso, é correto afirmar que X se distribui com uma
Durante um experimento de química analítica, um estudante realizou cinco determinações consecutivas da concentração de íons em uma solução padrão, obtendo os seguintes resultados em mol/L: 2,32; 2,41; 2,39; 2,45; 2,59. A equação da reta para esses dados é mostrada a seguir:
y = 0,058x + 2,258
Sabendo que a Soma Total dos Quadrados (SST) é igual a 0,04 e a Soma dos Quadrados dos Erros (SSE) é igual a 0,006, é correto afirmar que o coeficiente de determinação — R2 — é igual a
Foi realizado um levantamento em uma indústria de alto grau de risco, sendo identificado 10 óbitos nos últimos 5 anos, conforme a listagem a seguir:
Ano |
Número de óbitos |
Idade do óbito dos trabalhadores |
2019 |
4 |
22 |
42 | ||
35 | ||
60 | ||
2020 |
0 |
- |
2021 |
4 |
35 |
40 | ||
28 | ||
27 | ||
2022 |
1 |
38 |
2023 |
1 |
55 |
Considerando a idade para aposentadoria de 65 anos, assinale o valor correto para o índice Anos Potenciais Perdidos (APP).
Para resolver as questões 29 e 30, tome o texto seguinte como motivador
Distribuição Normal
A distribuição normal é um modelo bastante útil na estatística, e não seria uma surpresa pois a soma de efeitos independentes (ou efeitos não muito correlacionados) deveriam, se houvesse muitos desses, se distribuir normalmente (sempre sujeito a certos pressupostos).
Nos séculos dezoito e dezenove, alguns matemáticos e físicos desenvolveram uma função densidade de probabilidade que descrevia os erros experimentais obtidos em medidas físicas. De certa forma todo e qualquer processo de mensuração está sujeito a um erro de medida. Esse erro pode ter diferentes fontes, desde a variação de temperatura, tempo, entre inúmeras outras características não identificáveis.
Na época (século dezoito) a sua aplicação inicial era apenas como uma conveniente aproximação da distribuição binomial, mais tarde no século XIX a distribuição normal ganhou importância com os trabalhos de Abraham de Moivre (em The Doctrine of Chances), Pierre Simon Laplace e Carl Friedrich Gauss.
A grande utilidade dessa distribuição (função densidade de probabilidade) está associada ao fato de que aproxima de forma bastante satisfatória as curvas de frequências de medidas físicas, essa curva é conhecida como distribuição normal ou gaussina.
(In: https://www.inf.ufsc.br/~andre.zibetti/probabilidade/normal.html. Adaptado. Acessado em 8/1/2023)
Considerando que numa distribuição normal a curva é simétrica em relação á origem, a relação verdadeira entre os valores da média aritmética (MA), moda (Mo) e mediana (Me) é
Para resolver as questões 29 e 30, tome o texto seguinte como motivador
Distribuição Normal
A distribuição normal é um modelo bastante útil na estatística, e não seria uma surpresa pois a soma de efeitos independentes (ou efeitos não muito correlacionados) deveriam, se houvesse muitos desses, se distribuir normalmente (sempre sujeito a certos pressupostos).
Nos séculos dezoito e dezenove, alguns matemáticos e físicos desenvolveram uma função densidade de probabilidade que descrevia os erros experimentais obtidos em medidas físicas. De certa forma todo e qualquer processo de mensuração está sujeito a um erro de medida. Esse erro pode ter diferentes fontes, desde a variação de temperatura, tempo, entre inúmeras outras características não identificáveis.
Na época (século dezoito) a sua aplicação inicial era apenas como uma conveniente aproximação da distribuição binomial, mais tarde no século XIX a distribuição normal ganhou importância com os trabalhos de Abraham de Moivre (em The Doctrine of Chances), Pierre Simon Laplace e Carl Friedrich Gauss.
A grande utilidade dessa distribuição (função densidade de probabilidade) está associada ao fato de que aproxima de forma bastante satisfatória as curvas de frequências de medidas físicas, essa curva é conhecida como distribuição normal ou gaussina.
(In: https://www.inf.ufsc.br/~andre.zibetti/probabilidade/normal.html. Adaptado. Acessado em 8/1/2023)
Considere que para se normalizar uma certa distribuição, um estatístico tinha a sua disposição uma média amostral de 3 e uma variância amostral de 25. Para utilizar o desvio padrão amostral, o estatístico deve utilizar o valor
Em relação aos sistemas de medidas, noções de estatística e probabilidade, analise as assertivas abaixo e assinale V, se verdadeiras, ou F, se falsas.
( ) Dados analíticos são sempre baseados em valores de “pesos” para descrever as quantidades das substâncias ou objetos.
( ) Peso é uma medida invariável da quantidade de matéria contida em um objeto ou substância.
( ) As medidas sempre contêm erros e incertezas. A precisão indica a proximidade da medida com o valor real ou aceitável.
( ) Três termos são utilizados para descrever a precisão de um conjunto de dados em réplicas: desvio padrão, variância e coeficiente de variação.
A ordem correta de preenchimento dos parênteses, de cima para baixo, é:
Na rotina de laboratório é necessário analisar a resposta obtida dos experimentos realizados, ou seja, o conjunto de dados, calculando-se a média aritmética e o desvio padrão, por exemplo. Nesse contexto, analise as afirmações abaixo:
I. A variância é uma medida de dispersão que mostra o quão distante cada valor do conjunto está do valor médio.
II. O desvio padrão é a raiz quadrada da variância.
III. Quanto maior for a variância, mais próximos os valores estão da média.
Está CORRETO apenas o que se afirma em:
A tabela abaixo mostra o número de chutes a gols e o número de gols marcados para três jogadores de futebol durante um campeonato:
Jogador |
Chutes a gol |
Gols |
A |
190 |
38 |
B |
192 |
40 |
C |
95 |
20 |
Os estatísticos dos jogos calculam a efetividade de um jogador como sendo a razão entre o número de gols marcados e o número de chutes a gol. Pode-se dizer que os jogadores com maiores efetividades nesse campeonato foram, do maior para o menor:
Estatística é a ciência que estuda as técnicas necessárias para coletar, organizar, apresentar, analisar e interpretar os dados, a fim de extrair informações a respeito de uma população. Dentro da Estatística Descritiva, alguns elementos são essenciais para entender seus mecanismos de funcionamento. Como é chamado o conjunto de todos os elementos que têm pelo menos uma característica em comum, e que está sob investigação ou estudo?
Leia o texto abaixo para resolver as questões 27 e 28
Inflação nos EUA modera para 3,1% em janeiro, menos que o esperado
Os dados decepcionaram o mercado, que esperava uma inflação acumulada em 12 meses abaixo de 3%
A inflação nos Estados Unidos, uma questão central da campanha eleitoral americana, se moderou a 3,1% na comparação anual em janeiro, menos do que o esperado, segundo dados oficiais divulgados nesta terça-feira, 13.
O Índice de Preços ao Consumidor (IPC) teve um aumento anual de 3,1% em janeiro, em comparação com 3,4% na medição de dezembro, informou o Departamento do Trabalho. Os dados decepcionaram o mercado, que esperava uma inflação acumulada em 12 meses abaixo de 3% pela primeira vez desde março de 2021, quando a economia começava a sair da crise causada pela covid-19.
Os analistas apontaram para um aumento do IPC de 2,9%, segundo o consenso reunido pelo site especializado Market Watch. "Em um momento em que o crescimento e o emprego permanecem fortes, a inflação caiu dois terços do seu pico", observou o presidente Joe Biden em nota, na qual reiterou que "ainda há trabalho a fazer para reduzir os preços".
A inflação subjacente, que descarta os preços mais voláteis dos alimentos e da energia e é um dado fundamental para os mercados, se manteve em 3,9% em 12 meses.
O IPC moderou-se de um máximo de 9,1%, na comparação de 12 meses em junho de 2022, e caminha rumo ao objetivo de 2% anual, uma boa notícia para o Federal Reserve (Fed, banco central).
Após anos de taxas baixas, o banco central dos EUA aumentou drasticamente as suas taxas de juros de referência, em uma tentativa de arrefecer a economia. As taxas elevadas tornam o crédito mais caro e, assim, desencorajam o consumo e o investimento, diminuindo a pressão sobre os preços. As taxas estão agora nos níveis mais altos em mais de dois anos, de 5,25% a 5,50%, e a expectativa do mercado e do próprio Fed é começar a reduzi-las este ano.
[...]
(in: Inflação nos EUA modera para 3,1% em janeiro, menos que o esperado | Exame, acessado em 23/3/2024)
Supondo que o mercado esperasse um Índice de Preços ao Consumidor (IPC) 3,1%, qual seria a variância entre o IPC esperado pelo mercado e os IPCs de janeiro e dezembro informados pelo Departamento do Trabalho?
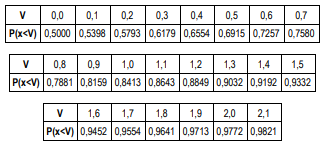
Se somarmos 9 amostras independentes da mesma variável aleatória de x, o valor mais próximo da probabilidade dessa soma ser maior que 1,8, entre as opções apresentadas a seguir, é:
O questionário básico do Censo 2022 trazia uma pergunta sobre o rendimento mensal do responsável pelo domicílio. Sabe-se que muitas pessoas não se sentem confortáveis revelando dados sobre renda. De fato, há evidências que sugerem que pessoas de alta renda tendem a declarar uma renda menor do que sua renda real e, analogamente, pessoas de baixa renda tendem a declarar rendas maiores do que as que realmente têm.
O impacto desse fenômeno sobre a distribuição dos dados de rendimento mensal do responsável pelo domicílio é de
“A construção de um teste de hipóteses, para um parâmetro populacional, pode ser colocada do seguinte modo. Existe uma variável X associada a dada população e tem-se uma hipótese sobre determinado parâmetro θ dessa população. Por exemplo, afirmamos que o verdadeiro valor de θ é θ0. Colhe-se uma amostra aleatória de elementos dessa população, e com ela deseja-se comprovar ou não tal hipótese”.
BUSSAB, Wilton de O.; MORETTIN, Pedro A. Estatística Básica. 9. ed. São Paulo: Saraiva Uni, 2017.
A respeito do teste de hipótese, ordene as etapas para a sistematização do teste de hipóteses.
( ) Fixe a probabilidade α de cometer o erro de tipo I e use este valor para construir a região crítica (regra de decisão).
( ) Use a teoria estatística e as informações disponíveis para decidir qual estatística (estimador) será usada para testar a hipótese H0. Obtenha as propriedades dessa estatística (distribuição, média, desvio padrão).
( ) Se o valor da estatística calculado com os dados da amostra não pertencer à região crítica, não rejeite H0; caso contrário, rejeite H0.
( ) Use as observações da amostra para calcular o valor da estatística do teste.
( ) Fixe qual a hipótese H0 a ser testada e qual a hipótese alternativa H1.
A ordem que demonstra a sistematização do teste de hipóteses é:

 Conheça nossos planos