Questões de Concurso Sobre programação
Foram encontradas 15.139 questões


Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331530
Programação
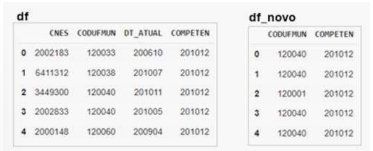
A biblioteca Pandas do Python possui diversas formas
para selecionar partes de um objeto dataframe. Utilizando
os dados disponíveis no dataframe df (imagem abaixo), um
programador deseja criar um dataframe (df_novo) contendo
somente as colunas CODUFMUN e COMPETEN. Das
opções abaixo, a única INCORRETA é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331529
Programação
No campo da saúde, é comum a adoção de métodos
para a reduzir a dimensionalidade dos dados, como a
segmentação de idades em faixas etárias. O comando
Python, com o uso da biblioteca Pandas (pd), que pode ser
utilizado para segmentar os valores de uma lista de idades
(tipo inteiro) em 10 faixas etárias, é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331528
Programação
Para reproduzir a transformação ilustrada na figura
abaixo, o código Python que faz uso da bilblioteca Pandas
(pd) e pode ser utilizado para para unir dois dataframes
(df1 e df2), criando o dataframe (df3), é:

Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331527
Programação
Dataframes da biblioteca Pandas no Python são muito
versáteis. Com eles é possível ler, processar, transformar e
exportar dados tabulares com grande eficiência. Considere
um dataframe criado a partir da leitura de um arquivo do tipo
csv (comma separated value). Só devem ser carregadas
as primeiras mil linhas das colunas A, B e C. Além disso,
todos os valores devem ser convertidos para o tipo string.
Os parâmetros e valores do método read_csv() que possibilitam isso são:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331514
Programação
Você é um cientista de dados trabalhando em um projeto
de pesquisa em saúde que envolve a análise de relatórios
médicos utilizando técnicas de Processamento de Linguagem Natural (PLN). Parte do seu trabalho é explorar as
relações semânticas entre diferentes condições de saúde
utilizando um modelo pré-treinado de word embeddings em
português, focado na área da saúde. Você decide investigar
a relação entre diferentes doenças e tratamentos.
Seja o seguinte código Python, que utiliza a biblioteca gensim e um modelo hipotético de word embeddings denominado modelo_saude.bin especializado em termos médicos em português:
import numpy as np from gensim.models import KeyedVectors
def calcular_similaridade(vetor_a, vetor_b): numerador = np.dot(vetor_a, vetor_b) denominador = np.linalg.norm(vetor_a) *
np.linalg.norm(vetor_b) similaridade = numerador / denominador return similaridade
mo del = Ke yed Vectors. load_ word 2vec _ format(‘modelo_saude.bin’, binary=True) vetor_diabetes = model[‘diabetes’] vetor_hipertensao = model[‘hipertensão’] vetor_insulina = model[‘insulina’]
vetor_diabetes_ajustado = vetor_diabetes + vetor_insulina vetor_hipertensao_ajustado = vetor_hipertensao + vetor_insulina
similaridade = calcular_similaridade(vetor_ diabetes_ajustado, vetor_hipertensao_ajustado) print(f”Similaridade: {similaridade}”)
Utilizando o modelo hipotético model_saude.bin, o resultado mostrado pelo código foi de 0.7036085724830627. Baseado no cenário descrito, no código fornecido e no resultado mostrado, a opção que melhor descreve o que está sendo calculado e o significado do resultado é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331512
Programação
Observe o código Python abaixo, que utiliza a biblioteca NLTK para tarefas de Processamento de Linguagem
Natural.
import nltk nltk.download(‘punkt’) from nltk.tokenize import word_tokenize
texto = “Fundação Oswaldo Cruz (Fiocruz): Ciência e tecnologia em saúde para a população brasileira.” tokens = word_tokenize(texto)
contador = 0 resultado = 0 while contador < len(tokens): for letra in tokens[contador]: if letra.upper() in ‘FIOCRUZ’: resultado += 1 contador += 1
O valor da variável resultado, ao final da execução do código, é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331508
Programação
O scikit-learn é uma biblioteca de aprendizado de máquina para Python que fornece uma ampla variedade de
classes e funções para análise de dados e modelagem de
Machine Learning. Ele inclui algoritmos para classificação,
regressão, clusterização, redução de dimensionalidade,
seleção de modelos, pré-processamento de dados, entre
outros.
Entre as opções abaixo, a que apresenta corretamente a combinação de classes e funções do scikit-learn usadas para implementar regressão do tipo polinomial e classificação com árvores de decisão é:
Entre as opções abaixo, a que apresenta corretamente a combinação de classes e funções do scikit-learn usadas para implementar regressão do tipo polinomial e classificação com árvores de decisão é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331506
Programação
Além da linguagem Python, a linguagem R é uma
poderosa ferramenta estatística e gráfica utilizada por cientistas de dados em todo o mundo. Originária do ambiente
acadêmico e com forte apoio da comunidade de estatística,
R rapidamente se consolidou como uma das linguagens de
programação de escolha para análise de dados, pesquisa
científica, e qualquer aplicação que exija manipulação intensiva de dados, análise estatística ou visualização gráfica.
Considere o sumário exibido abaixo, saída do comando summary(df) da linguagem R:

Com base nesta informação, a opção que contém uma observação INCORRETA é:
Considere o sumário exibido abaixo, saída do comando summary(df) da linguagem R:
Com base nesta informação, a opção que contém uma observação INCORRETA é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331505
Programação
Além do Pandas, NumPy, que é um acrônimo para
Numerical Python, é outra biblioteca fundamental para a
computação em Python. Ela serve como um dos pilares
do ecossistema de ciência de dados e análise numérica,
oferecendo suporte para poderosas estruturas de dados de
arrays e matrizes multidimensionais.
Seja o dataframe Pandas df carregado da tabela Financiamento e um extrato de seus dados mostrado abaixo.

E seja o seguinte código NumPy, que transforma df em matriz e manipula suas linhas e colunas.
import numpy as np matriz = df.values subconjunto = matriz[matriz[:, 1] == 1, 4:6]
Das opções abaixo, a que apresenta corretamente o array extraído pela operação NumPy é:
Seja o dataframe Pandas df carregado da tabela Financiamento e um extrato de seus dados mostrado abaixo.
E seja o seguinte código NumPy, que transforma df em matriz e manipula suas linhas e colunas.
import numpy as np matriz = df.values subconjunto = matriz[matriz[:, 1] == 1, 4:6]
Das opções abaixo, a que apresenta corretamente o array extraído pela operação NumPy é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - TE56 - Cientista de Dados em Saúde |
Q3331504
Programação
Quando se trabalha com grandes conjuntos de dados
no Pandas, a eficiente alocação de memória torna-se crucial
para manter um bom desempenho e evitar o esgotamento
dos recursos do sistema. Dado este desafio, analise as
opções abaixo para otimizar o uso da memória ao manipular
grandes volumes de dados com Pandas.
I. Empregar categorias para dados textuais repetitivos ao invés de strings.
II. Segmentar os dados em chunks menores durante a leitura de arquivos grandes, utilizando o parâmetro chunksize no read_csv.
III. Fazer uso intensivo de operações inplace.
Sobre as afirmativas acima, pode-se dizer que:
I. Empregar categorias para dados textuais repetitivos ao invés de strings.
II. Segmentar os dados em chunks menores durante a leitura de arquivos grandes, utilizando o parâmetro chunksize no read_csv.
III. Fazer uso intensivo de operações inplace.
Sobre as afirmativas acima, pode-se dizer que:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - Bioinformática |
Q3331211
Programação
O Biopython é amplamente utlizado para realizar
análises na área da Bioinformática. A interface Bio.SeqIO
é utlizada para realizar a entrada e saída de arquivos suportando muitos formatos distintos. Considerando o código
abaixo, é correto afirmar que:

Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - Bioinformática |
Q3331210
Programação
Os clusteres de alto desempenho focam em maximizar
o desempenho para tarefas computacionais intensivas.
Contudo, para se fazer um bom uso dos recursos de um
cluster é necessário o conhecimento de modelos de programação paralela como o MPI (Message Passing Interface)
e o OpenMP. Nesse contexto, é correto afirmar que:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - Bioinformática |
Q3331208
Programação
Python é uma linguagem de programação amplamente
utilizada na Bioinformática. Através do lambda é possível
criar funções anônimas. O código que está sintaticamente
correto, de acordo com a versão da linguagem Python
superior a 3.10, é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - Bioinformática |
Q3331203
Programação
O formato de configuração que corresponde ao comumente utilizado para definir parâmetros e configurações
em linguagem de fluxo computacional como Snakemake
e Nextflow é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - Bioinformática |
Q3331188
Programação
Expressões regulares compreendem uma ferramenta
de extrema importância para o processamento de arquivos
de texto visando a detecção de padrões. Na bioinformática,
expressões regulares são comumente utilizadas para
detectar padrões de texto. A linguagem de programação
python contém suas funcionalidades de expressão regular
implementadas no módulo re. Considerando um arquivo
texto contendo as sete linhas abaixo, a opção com o
número de linhas distintas, que seriam selecionadas pela
expressão regular ‘^ID\d+\.\d+$’, é:
ID34343.A ID34HN43.1 ID985433230 ID852495_23 _ID423243.1 ID2544343.97 ID1.1
ID34343.A ID34HN43.1 ID985433230 ID852495_23 _ID423243.1 ID2544343.97 ID1.1
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - ecnologia da informação e comunicação (TIC) com foco em análise e desenvolvimento de sistema |
Q3331039
Programação
Ao criar um projeto com o Framework Laravel versão
10.x, uma estrutura padrão de diretórios é criada com
objetivo de fornecer um ponto de partida para o
desenvolvimento de aplicações. Quanto a essa estrutura
padrão de diretórios, é INCORRETO afirmar que:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - ecnologia da informação e comunicação (TIC) com foco em análise e desenvolvimento de sistema |
Q3331038
Programação
O Laravel é um dos frameworks para
desenvolvimento de aplicações web em linguagem de
programação PHP mais difundidos. Integrado ao Laravel
versão 10.x há outro framework, conhecido como
Eloquent ORM (Object Relational Mapping). Os métodos
abaixo pertencem ao framework Eloquent ORM,
EXCETO:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - ecnologia da informação e comunicação (TIC) com foco em análise e desenvolvimento de sistema |
Q3331034
Programação
Uma página web responsiva é criada para se adaptar
ao tamanho da tela do dispositivo no qual está sendo
exibida. Um dos frameworks utilizados para criar páginas
web responsivas é:
Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - ecnologia da informação e comunicação (TIC) com foco em análise e desenvolvimento de sistema |
Q3331029
Programação
O resultado da execução do algoritmo abaixo em linguagem de programação Python 3 é:

Ano: 2024
Banca:
FIOCRUZ
Órgão:
FIOCRUZ
Prova:
FIOCRUZ - 2024 - FIOCRUZ - Tecnologista em Saúde Pública - ecnologia da informação e comunicação (TIC) com foco em análise e desenvolvimento de sistema |
Q3331017
Programação
Exemplos de métodos da classe UserControl (contida
no namespace System.Web.UI) do ASP.NET incluem:

 Conheça nossos planos