Questões de Concurso
Sobre data mining em banco de dados
Foram encontradas 581 questões


Situação hipotética: Na ação de obtenção de informações por meio de aprendizado de máquina, verificou-se que o processo que estava sendo realizado consistia em examinar as características de determinado objeto e atribuir-lhe uma ou mais classes; verificou-se também que os algoritmos utilizados eram embasados em algoritmos de aprendizagem supervisionados. Assertiva: Nessa situação, a ação em realização está relacionada ao processo de classificação.
Considerando essas informações, julgue o item que segue.
Se um sistema de informação correlaciona os dados da tabela
em questão com outros dados não estruturados, então, nesse
caso, ocorre um processo de mineração de dados.
Tendo como referência as informações apresentadas, julgue o item seguinte.
Pelo monitoramento do tráfego de rede no acesso ao sítio em questão, uma aplicação que utiliza machine learning é capaz de identificar, por exemplo, que os acessos diminuíram 20% em relação ao padrão de acesso em horário específico do dia da semana.
Tendo como referência as informações apresentadas, julgue o item seguinte.
Dados coletados de redes sociais podem ser armazenados, correlacionados e expostos com o uso de análises preditivas.
Acerca de banco de dados, julgue o seguinte item.
Descobrir conexões escondidas e prever tendências futuras
é um dos objetivos da mineração de dados, que utiliza
a estatística, a inteligência artificial e os algoritmos
de aprendizagem de máquina.
Acerca de banco de dados, julgue o seguinte item.
A mineração de dados se caracteriza especialmente pela
busca de informações em grandes volumes de dados, tanto
estruturados quanto não estruturados, alicerçados no conceito
dos 4V’s: volume de mineração, variedade de algoritmos,
velocidade de aprendizado e veracidade dos padrões.
Julgue o item que se segue, a respeito de tecnologias de sistemas de informação.
Na busca de padrões no data mining, é comum a utilização
do aprendizado não supervisionado, em que um agente
externo apresenta ao algoritmo alguns conjuntos de padrões
de entrada e seus correspondentes padrões de saída,
comparando-se a resposta fornecida pelo algoritmo com a
resposta esperada.
Analise as afirmativas a seguir referentes à Mineração de Dados.
I. Cada método de mineração de dados requer diferentes necessidades de pré-processamento. Tais necessidades variam em função do aspecto extensional da base de dados em que o método será utilizado.
II. Os métodos de Knowledge Discovery in Databases (KDD), sendo os métodos de Mineração de Dados um caso particular, podem ser considerados operadores definidos a partir de pré-condições e efeitos.
III. Diversos modelos de Redes Neurais Artificiais podem ser utilizados na implementação de métodos de Mineração de Dados.
Assinale a alternativa CORRETA.
Julgue o item que se segue, a respeito de arquitetura e tecnologias de sistemas de informação.
A descoberta de novas regras e padrões em conjuntos de dados
fornecidos, ou aquisição de conhecimento indutivo, é um dos
objetivos de data mining.
Julgue o item que se segue, acerca de data mining e data warehouse.
O processo de mineração de dados está intrinsecamente ligado
às dimensões e a fato, tendo em vista que, para a obtenção de
padrões úteis e relevantes, é necessário que esse processo seja
executado dentro dos data warehouses.
Considere o conjunto de dados a seguir, obtido a partir de uma base de dados de transações ocorridas em uma padaria, em uma determinada faixa de tempo. Nesse conjunto, indica-se a ocorrência de um determinado produto em cada transação.
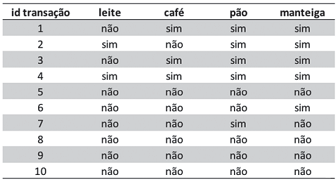
Em mineração de dados, a partir desse conjunto de dados, podem ser geradas regras de associação, as quais buscam conjuntos de itens frequentes que guardam entre si uma relação de causa e efeito. Essas regras são da forma X→Y, onde X é o antecedente da regra, e Y, seu consequente. A menção X,Y indica referência aos dois itens frequentes X e Y. Dois indicadores utilizados para averiguar a eficácia de regras de associação são o suporte e a confiança.
Qual das regras a seguir possui confiança mínima de
80%, dado um suporte mínimo de 30%?
Dois funcionários de uma empresa de crédito discutiam sobre quais algoritmos deveriam usar para ajudar a classificar seus clientes como bons ou maus pagadores. A empresa possui, para todos os empréstimos feitos no passado, um registro formado pelo conjunto de informações pessoais sobre o cliente e de como era composta a dívida inicial. Todos esses registros tinham classificações de bons ou maus pagadores, de acordo com o perfil de pagamento dos clientes. A partir desses dados, os funcionários querem construir um modelo, por meio de aprendizado de máquina, que classifique os novos clientes, que serão descritos por registros com o mesmo formato.
A melhor opção, nesse caso, é usar um algoritmo

 Conheça nossos planos