Questões de Concurso
Sobre data mining em banco de dados
Foram encontradas 581 questões


Uma árvore de decisão representa um determinado número de caminhos possíveis de decisão e os resultados de cada um deles, apresentando muitos pontos positivos, ou seja, são fáceis de entender e interpretar. Elas têm processo de previsão completamente transparente e lidam facilmente com diversos atributos numéricos, assim como atributos categóricos, podendo até mesmo classificar dados sem atributos definidos.
De acordo com os aspectos construtivos de uma árvore de decisão, julgue o item a seguir.
Se o processo adotado para a construção de árvores de
decisão for determinístico, uma forma de obtenção de
árvores aleatórias, que compõem as florestas aleatórias, pode
ser realizada por meio do bootstrap dos dados, em que cada
árvore é treinada com base no resultado de bootstrap_sample
(inputs).
A partição que apresenta o menor erro de classificação quando feita na raiz (primeiro nível) de uma árvore de decisão é:
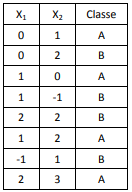
Esse analista gostaria de prever a classe dos pontos (1,1), (0,0) e (-1,2) usando o algoritmo de k-vizinhos mais próximos com k=3 e usando a distância euclidiana usual.
Suas classes previstas são, respectivamente:
Com relação a data warehouse e data mining, julgue o item subsequente.
A análise de data mining por padrão sequencial visa à
identificação de fatos que geram outros fatos, sempre
ocorrendo causa e consequência em momentos adjacentes.
Com relação a data warehouse e data mining, julgue o item subsequente.
A etapa de estratificação da técnica de árvore de decisão é
responsável por determinar as regras para a designação dos
casos identificados a uma categoria existente mais adequada
no data mining.
Utilize a figura a seguir (Fig3), que representa uma sequência de comandos em SQL, para resolver as questões de número 54 e 55.
Fig3
create table cliente
{
seq VARCHAR2(6) not null,
nome VARCHAR2(50) not null,
cpf VARÇHAR2(11) not null,
data nasc date,
dependentes numeric(2),
estcivil VARCHAR2(1)
);
arter table cliente
ADD CONSTRAINT cliente pk PRIMARY KEY (cpf)
ADD CONSTRAINT seq un unique (seq) enable
ADD CONSTRAIKT est ck check (estcivil in ('C','S','D','V')) enable
ADD CONSTRAINT cpf ch check (REGEXP LIKE(cpf, '^[[digit: ]]{11}$')) enable;
Como se chama o processo de explorar grandes quantidades de dados à procura de anomalias, padrões e correlações consistentes, tais como regras de associação ou sequências temporais, para detectar relacionamentos sistemáticos entre variáveis, detectando assim novos subconjuntos de dados?
A detecção de novos tipos de fraudes é uma das aplicações comuns da técnica de modelagem descritiva da mineração de dados, a qual viabiliza o mapeamento rápido e preciso de novos tipos de golpes por meio de modelos de classificação de padrões predefinidos de fraudes.

 Conheça nossos planos