Questões de Concurso
Sobre data mining em banco de dados
Foram encontradas 581 questões


O modelo de referência CRISP-DM, composto por quatro fases não cíclicas, permite o fluxo unidirecional, ou seja, pode ir e voltar entre as fases.
Atualmente, conforme a tecnologia evolui, novos termos vão surgindo, particularmente com o aumento da importância dos dados na criação de estratégias de crescimento e tomadas de decisão. Nesse contexto, dois termos se destacam, descritos a seguir:
I. É um repositório central de informações que podem ser analisadas para tomar decisões mais adequadas. Os dados fluem de sistemas transacionais, bancos de dados relacionais e de outras fontes. Analistas de negócios, engenheiros de dados, cientistas de dados e tomadores de decisões acessam os dados por meio de ferramentas de inteligência de negócios (BI), clientes SQL e outros aplicativos de análise.
II. É um processo analítico no qual grande quantidade de dados são explorados com o objetivo de encontrar padrões relevantes ou relação sistemática entre variáveis, os quais são validados. Todo esse processo acontece em três etapas: exploração, construção de modelo (padrão) e validação. As ferramentas empregadas analisam dados em busca de oportunidades ou problemas e fazem o diagnóstico do comportamento dos negócios. Sendo assim, cabe ao usuário utilizar o conhecimento para produzir vantagens competitivas.
Os termos descritos em I e II representam os conceitos, respectivamente, de:
I. Dado dois conjuntos de registros com N e M registros (onde N<<M) vinculados a duas classes, o balanceamento por seleção aleatória ocorre selecionando de forma aleatória N registros dentro do conjunto contendo M registros.
II. Dado dois conjuntos de registros com N e M registros (onde N<<M) vinculados a duas classes, o balanceamento por seleção de grupo ocorre selecionando por meio de uma técnica de agrupamento os N registros mais representativos dentro do conjunto contendo M registros.
III. Dado dois conjuntos de registros com N e M registros (onde N<<M) vinculados a duas classes, o balanceamento ocorre gerando artificialmente instâncias a partir das instâncias do conjunto contendo M registros (classe maioritária).
Quais estão INCORRETAS?
Quanto à mineração de dados e ao CRISP-DM (Cross-Industry Standard Process for Data Mining), julgue o item.
No modelo CRISP-DM, a modelagem é uma das fases
mais importantes do processo, consistindo no
conhecimento do domínio do negócio, ou seja, no
conhecimento e na compreensão dos objetivos do
projeto de mineração a partir da perspectiva do negócio.
Quanto à mineração de dados e ao CRISP-DM (Cross-Industry Standard Process for Data Mining), julgue o item.
O modelo CRISP-DM é bastante utilizado graças à sua
rigidez quanto à execução de cada uma de suas fases; ele
não permite que um projeto retorne a uma etapa ou fase
anterior, pois a sequência de fases é rigorosa e deve ser
seguida.
Quanto à mineração de dados e ao CRISP-DM (Cross-Industry Standard Process for Data Mining), julgue o item.
Compreensão dos dados e preparação dos dados são
fases do modelo CRISP-DM.
Quanto à mineração de dados e ao CRISP-DM (Cross-Industry Standard Process for Data Mining), julgue o item.
Listagens, saídas gráficas, tabelas de resumo ou
visualizações são formatos usados na apresentação dos
resultados da mineração de dados.
Quanto à mineração de dados e ao CRISP-DM (Cross-Industry Standard Process for Data Mining), julgue o item.
A mineração de dados é uma técnica que objetiva
adquirir conhecimento a partir dos dados, por meio da
detecção de vários tipos de padrões em grandes
volumes de dados.
Como resultado, foi criado o modelo de árvore de decisão ilustrado a seguir.
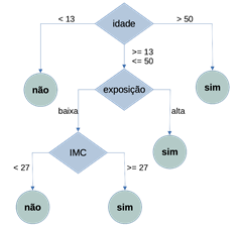
Uma evidência de que esse modelo foi construído usando o algoritmo C4.5 ou uma de suas variantes é:
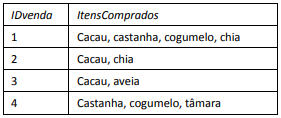
Utilizando técnicas de Mineração de Dados, Maria encontrou a seguinte informação:
Se um cliente compra Cacau, a probabilidade de ele comprar chia é de 50%. Cacau => Chia, suporte = 50% e confiança = 66,7%.
Para explorar a base de dados do HortVega, Maria utilizou a técnica de Mineração de Dados:
Com relação a data warehouse e data mining, julgue o item a seguir.
A análise de cluster em data mining permite, por meio de
análise exploratória de dados, ordenar casos em clusters, de
modo que o grau de associação seja forte entre os membros
do mesmo cluster e fraco entre membros de clusters
diferentes.
A respeito de data warehouse, data mining e business intelligence, julgue o item subsequente.
Sistemas de data mining viabilizam a extração de novos
padrões significativos de informação que não seriam
necessariamente encontrados por meio de meras consultas ou
processamento de dados ou metadados no data warehouse.
Com referência aos conceitos e técnicas de mineração de dados, julgue o item seguinte.
Em um modelo para um aprendizado supervisionado dos
dados no formato de uma árvore de decisão, um algoritmo de
construção da árvore busca minimizar a informação
necessária para classificar os dados nas partições da árvore.
Com referência aos conceitos e técnicas de mineração de dados, julgue o item seguinte.
No aprendizado não supervisionado dos dados, usa-se uma
amostra para treinamento, e os registros são colocados em
agrupamentos semelhantes entre si quanto aos seus padrões.
Com referência aos conceitos e técnicas de mineração de dados, julgue o item seguinte.
Para encontrar regras de associação negativas de interesse,
como a identificação de padrões nos dados de um arquivo, a
hierarquia é uma técnica usada com base no conhecimento
prévio sobre um conjunto de atributos do arquivo.
A respeito de inteligência do negócio, julgue o item a seguir.
Os conceitos de data warehouse (DW) e data mining (DM)
são relacionados à inteligência de negócios; a principal
diferença entre eles é que o DW atua na análise dos eventos
do passado, enquanto o DM limita-se na predição dos
eventos futuros.
Com respeito a análise de componentes principais, mistura de gaussianas e agrupamento k-means, julgue o item que se segue.
Considere que, em uma análise de agrupamentos por meio de
mistura de gaussianas, três distribuições normais com médias  se referem, respectivamente, aos clusters 1, 2 e 3.
Nessa situação, pelo modelo de mistura de gaussianas, o
cluster 1 é constituído pelas observações mais próximas da
média

O ensemble denominado bagging tem como foco principal a redução do viés e não da variância, treinando-se os modelos em sequência, tal que os erros dos primeiros modelos treinados são utilizados para o ajuste nos pesos matemáticos dos próximos modelos.

 Conheça nossos planos