Questões de Concurso
Sobre testes de hipóteses em estatística
Foram encontradas 515 questões


Esse procedimento é amplamente utilizado em pesquisas científicas, estudos de mercado e controle de qualidade, contribuindo para a tomada de decisões fundamentadas em evidências.
Com relação aos testes de hipóteses, analise as afirmativas a seguir.
I. Em testes com hipóteses compostas são avaliadas três ou mais hipóteses simultaneamente.
II. O aumento da potência do teste implica maior probabilidade de obtenção de p-valores elevados.
III. O nível de significância é um limiar previamente definido usado para decidir pela rejeição ou não da hipótese nula (H0).
Está correto o que se afirma em
Sobre o tema, leia o fragmento a seguir.
“O Erro do Tipo I ocorre quando o pesquisador ___________ uma hipótese nula que é, na realidade, ___________. Já o Erro do Tipo II ocorre quando o pesquisador deixa de rejeitar uma hipótese nula que é falsa. A probabilidade de cometer o Erro do Tipo I é dada pelo nível de ___________ do teste.”
Assinale a opção que apresenta os termos que preenchem corretamente as lacunas do fragmento acima.
Determinada prefeitura realizou um estudo para comparar o tempo médio (em horas) necessário para análise de processos administrativos em três regionais diferentes da secretaria de fazenda. Para isso, foram selecionadas amostras independentes de processos analisados em cada regional. Os resultados observados foram:
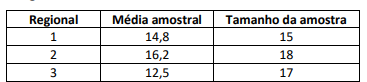
Considerando que os tempos seguem uma Distribuição Normal nas três regionais e que as variâncias populacionais podem ser consideradas iguais, realizou-se uma análise de variância (ANOVA) para verificar se existe diferença significativa entre os tempos médios de análise nas três regionais. A soma de quadrados entre grupos foi igual a 288 e a soma de quadrados total foi igual a 468. Denotando por Fx,y uma variável aleatória com distribuição F de Fisher-Snedecor com x graus de liberdade no numerador e y graus de liberdade no denominador, então o valor-p do teste de hipóteses associado é dado por:
Considere que determinada secretaria municipal de meio ambiente deseja avaliar se a concentração média de partículas poluentes emitidas por pequenas indústrias de uma região urbana está em conformidade com o limite histórico de 50 unidades estabelecido em norma ambiental do município. Admita que a concentração de poluentes siga uma Distribuição Normal com variância populacional conhecida igual a σ² = 64. Uma amostra aleatória de tamanho n = 16 foi coletada, obtendo-se média amostral igual a X̄ = 52. Deseja-se testar a hipótese nula H₀: μ = 50 contra a hipótese alternativa de que H₁: μ ≠ 50. Considere, ainda, que a região crítica do teste é dada por RC = { |X̄ - 50| > 4 } e que, caso H₀ seja falsa, o verdadeiro valor da média populacional seja μ = 52. Com base nessas informações, o valor-p bilateral e o poder do teste são, respectivamente, iguais a:
(Dados adicionais: Φ(0,5) = 0,69; Φ(1,5) = 0,93; Φ(2) = 0,98; e Φ(3) ≅ 1; em que Φ(z) representa a função de distribuição acumulada da Distribuição Normal Padrão no ponto z).
• Estimativa do intercepto do modelo = 4,5; • Estimativa do coeficiente de X1 = 1,6; • Estimativa do coeficiente de X2 = 0,25; • Soma de quadrados da regressão = 540,0; • Soma de quadrados dos resíduos = 60,0; e • Valor-p do teste F da ANOVA = 0,003.
Com base nessas informações, assinale a afirmativa INCORRETA.
No âmbito da análise de produtos entregues por consultorias contratadas pela INFRA S.A. para a caracterização de solos ferroviários, o fiscal deve validar a redução de dimensionalidade de dados multivariados. Acerca de métodos estatísticos e suas análises nesse contexto, julgue o item a seguir.
No âmbito de um teste de hipóteses para monitoramento do impacto de um poluente, o erro do tipo I (a) ocorre quando o pesquisador rejeita a hipótese nula (H0) de que não há impacto quando, na verdade, o impacto não existe.
Um gestor público de políticas de desenvolvimento agrícola deseja avaliar se três diferentes fórmulas de biofertilizante (F1, F2, F3) produzem efeitos distintos sobre o crescimento inicial de mudas de espécies nativas destinadas a projetos de recuperação de áreas degradadas. Para isso, foi conduzido um experimento completamente casualizado com 60 parcelas homogêneas. As parcelas foram aleatorizadas para receber um dos três fertilizantes (n = 20 por grupo). A variável resposta é o incremento em altura (cm) após 60 dias. Após a coleta dos dados, o gestor observa que a distribuição dos resíduos do modelo apresenta leve assimetria à direita e caudas ligeiramente mais pesadas que a distribuição normal. Ele decide testar a homogeneidade das variâncias entre os grupos (teste de Levene, p = 0,12). O tamanho amostral por grupo é razoável (n = 20), e o interesse primário é comparar as médias dos três grupos, controlando o erro tipo I em 5%.
Com base nesse cenário e nos princípios de estatística experimental, assinale a alternativa CORRETA quanto à técnica mais apropriada para a análise dos dados, justificando os pressupostos e possíveis alternativas.
Ao realizar um teste de hipóteses para a média de uma população com amostras pequenas (n < 30) e desvio padrão populacional desconhecido, a distribuição t de Student é a mais apropriada para construir o intervalo de confiança ou calcular o valor p. Em relação à teoria da distribuição t e sua aplicação, julgue os itens a seguir:
I. A estatística de teste 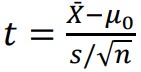 segue exatamente uma
distribuição t de Student com n − 1 graus de liberdade
se a população for normal. Se a população não for
normal, mas for simétrica e com curtose moderada, o
teste t ainda é razoavelmente robusto para amostras
pequenas.
II. A distribuição t de Student tem caudas mais pesadas que a distribuição Normal padrão, mas à medida que os graus de liberdade aumentam, a t se aproxima da Normal. Para n ≥ 30, a diferença é geralmente considerada desprezível na prática.
III. O intervalo de confiança para a média usando a
distribuição t é dado por 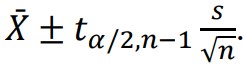 Se,
erroneamente, usássemos o quantil da Normal (Zα/2) no
lugar do t, o intervalo seria mais estreito, aumentando a
probabilidade de não conter o verdadeiro parâmetro
(cobertura abaixo do nominal).
IV. Para testar a média de uma população com amostra pequena e desvio padrão desconhecido, a distribuição Qui-quadrado (X 2) seria apropriada se o interesse fosse na variância, não na média. Já a distribuição F é usada para comparação de duas variâncias ou em ANOVA.
V. A estatística t de Student para uma amostra pode ser derivada como razão entre uma Normal padrão e a raiz quadrada de uma Qui-quadrado dividida por seus graus de liberdade, assumindo independência. Essa relação justifica o nome “t” e a forma da densidade.
Assinale a alternativa com a sequência CORRETA (V/F):
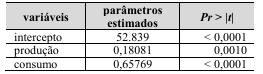
Acerca da modelagem estatística de dados, julgue o item a seguir.
Testes t e F em regressão linear dependem, em sua formação clássica, da validade da estrutura de variância assumida pelo modelo.
Considerando que o valor crítico para α = 0,05 é 3,84 e para α = 0,01 é 6,63, e sabendo que o teste qui-quadrado mede a discrepância entre frequências observadas e esperadas sob a hipótese de independência, é correto afirmar que
Com base nos fundamentos da inferência estatística, assinale a alternativa correta.
Em um estudo epidemiológico conduzido com trabalha dores expostos a solventes orgânicos, avaliou-se a associação entre tempo de exposição e redução da velocidade de condução nervosa. A análise estatística apresentou valor de p = 0,04 para o coeficiente de regressão linear, e o intervalo de confiança de 95% para a diferença média entre expostos e não expostos variou de –2,1 a –0,3 ms.
Considerando esses achados, assinale a alternativa correta.
Com base nesse contexto, avalie as proposições:
I. Um teste de hipótese pode ser utilizado para avaliar se a diferença entre médias observada é compatível com variações amostrais.
II. O nível de significância (α ) está relacionado à probabilidade de rejeitar a hipótese nula quando ela é verdadeira.
Assinale a alternativa CORRETA.
x<-c(15,20,30,25,38,36,18,23,10,22,35,33,12,28,25)
y<-c(1.57,1.56,1.63,1.60,1.65,1.64,1.58,1.59,1.58,
1.57,1.63,1.61,1.57,1.63,1.57)
plot(x,y) cor.test(x,y) summary(regressao<- lm(y~x)) plot(regressao)
É correto afirmar que as linhas de programa fornecem, respectivamente, os seguintes resultados:

 Conheça nossos planos