Questões de Concurso Para analista de tecnologia da informação

Foram encontradas 21.308 questões

Resolva questões gratuitamente!

Junte-se a mais de 4 milhões de concurseiros!

Q4347013 Banco de Dados
Considerando-se alguns dos comandos SQL, marcar C para as afirmativas Certas, E para as Erradas e, após, assinalar a alternativa que apresenta a sequência CORRETA:

(_) DROP DATABASE Procempa: duplica o Banco de Dados “Procempa”.
(_) CREATE TABLE Analistas (id INT PRIMARY KEY, cpf VARCHAR(50)): cria uma tabela chamada “Analistas”, a qual terá uma coluna “id” idêntica para todos os analistas (chave-primária) e uma coluna “cpf” que aceita no máximo 50 caracteres e somente do tipo número.
(_) ALTER TABLE Analistas ADD idade INT: promove uma alteração da tabela “Analistas” com a inserção de um novo campo (coluna) chamado “idade”. 
Alternativas
Q4347012 Programação
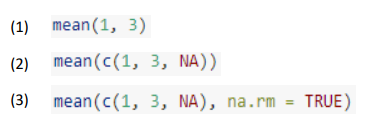
No R, a função mean() calcula a média de um conjunto de valores. Sendo assim, considerando-se as saídas dos códigos indicados abaixo, numerar a 2ª coluna de acordo com a 1ª e, após, assinalar a alternativa que apresenta a sequência CORRETA:

Imagem associada para resolução da questão

(_) NA (_) 1 (_) 2
Alternativas
Q4347011 Programação
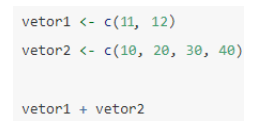
Tendo em vista que vetores são estruturas muito importantes em R, em relação ao caso abaixo, a saída do código será:

Imagem associada para resolução da questão
Alternativas
Q4347010 Programação
No R, para obter subconjuntos de um vetor, é necessário realizar operações de indexação. Isto é, associar ao vetor um outro vetor de mesmo tamanho com os índices dos elementos selecionados. Nesse sentido, para indexar subconjuntos (subsets) de objetos no R, utiliza-se o operador:
Alternativas
Q4347009 Banco de Dados
Considerando-se as funções DAX disponíveis no Power BI Desktop, assinalar a fórmula que soma todos os números contidos na coluna “Frete” da tabela “Vendas”:
Alternativas
Q4347008 Programação

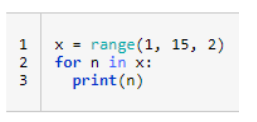
Considerar o código Python abaixo:


Imagem associada para resolução da questão


A execução desse código exibe: 

Alternativas
Q4347007 Banco de Dados
 A Mineração de Dados é comumente classificada por sua capacidade em realizar determinadas tarefas. Em uma auditoria, por exemplo, separar comportamentos suspeitos, é uma tarefa realizada pelo(a): 
Alternativas
Q4347006 Estatística
 Em relação ao modelo clássico de regressão linear, assinalar a alternativa INCORRETA:
Alternativas
Q4347005 Estatística
Para ajustar um modelo de regressão logística, é necessário estimar os parâmetros β0 e β1 do modelo. Para isso, utiliza-se o método:
Alternativas
Q4347004 Estatística
 Ao utilizar o algoritmo K-means, a forma mais simples de verificarmos a “qualidade” dos clusters encontrados, a fim de que se possa dizer o quão distantes estão os clusters dos outros, é por meio da:
Alternativas
Q4347003 Programação

Redes neurais são uma classe de modelos que são construídos com camadas, entre as quais as mais comumente utilizadas incluem redes neurais convolucionais (CNN) e recorrentes (RNN). Funções de ativação (activation function) são usadas no fim de uma unidade escondida para introduzir complexidades não lineares ao modelo. Assinalar a alternativa que se refere à função de ativação que tem sido mais utilizada em Deep Learning, por facilitar o processo de treinamento, por não saturar a partir de um determinado ponto, e ser simplesmente a função identidade para valores positivos:

Alternativas
Q4347002 Noções de Informática
Em relação à arquitetura de Redes Neurais Convolucionais e Recorrentes, assinalar a alternativa CORRETA:
Alternativas
Q4347001 Estatística
Ao construir um classificador usando machine learning, um desenvolvedor deve se perguntar o quão bom é seu modelo para predição. Assim, ao treinar um modelo de aprendizagem, algumas métricas podem ser utilizadas para avaliação. Considerando a legenda abaixo, pode-se afirmar que a Especificidade e a Precisão, são calculadas pelas seguintes fórmulas, respectivamente:

VP: verdadeiros positivos; FN: falsos negativos; FP: falsos positivos; VN: verdadeiros negativos; P: precisão; S: sensibilidade; N: total de elementos.
Alternativas
Q4347000 Engenharia de Software
Existem diversas metodologias já desenvolvidas, e em desenvolvimento, de modelos de classificação supervisionada. Nesse sentindo, a melhor metodologia é aquela que se ajusta melhor aos seus dados e que é capaz de trazer as melhores respostas de acordo com o seu objetivo. A vantagem e desvantagem listada abaixo nos itens I e II, respectivamente, entre os diversos modelos de Classificação Supervisionada, referem-se a:

I. Controle de Overfitting. II. Interpretabilidade das variáveis.
Alternativas
Q4346999 Banco de Dados
Entre as principais tarefas de pré-processamento de dados fortemente dependentes de domínio, assinalar a alternativa que é exemplificada na situação descrita abaixo:

Uma empresa de cartão de crédito cujo banco de dados possuía um campo “gender” para armazenar o sexo de seus clientes. Alguns registros assumiam, entretanto, o valor B para esse atributo, o qual, posteriormente, descobriu-se que correspondia à informação Business. Originalmente, o sistema tinha sido projetado somente para cadastrar cartões para pessoas físicas, porém, quando cartões para empresas foram permitidos, não havia um campo específico para indicar que o cadastrado era uma empresa. Essa informação foi então armazenada no campo “gender”.
Alternativas
Q4346998 Engenharia de Software
 A respeito dos conceitos de Deep Learning, analisar os itens abaixo:

I. Redes profundas híbridas se destacam pela discriminação que é assistida, muitas vezes de forma significativa, com os resultados de redes profundas generativas ou não supervisionadas. Isso pode ser alcançado por meio de uma melhor otimização e regularização das redes profundas supervisionadas. A proposta dessa rede também pode ser alcançada quando critérios discriminativos para a aprendizagem supervisionada são usados para estimar os parâmetros em qualquer das redes profundas generativas ou não supervisionadas.
II. Em termos de topologia, para implementar uma RNA, deve-se definir diferentes variáveis, dentre as quais: o número de nós na camada de entrada, o número de camadas escondidas, o número de neurônios a serem colocados nessas camadas, e o número de neurônios na camada de saída.
III. As redes neurais com treinamento não supervisionado, os algoritmos de agrupamento e a mineração de dados com regras de associação possuem a grande vantagem de que não é necessário conhecer a classe de saída de cada item de dado e, alguns casos, nem a quantidade de classes de saída.

Está(ão) CORRETO(S):
Alternativas
Q4346997 Engenharia de Software
 As fases do CRISP-DM não são necessariamente executadas em sequência, uma vez que durante o processo podem ocorrer alterações e ser modificada a sequência. A formação de hipóteses em cima do que se aprendeu com os dados, é executada em qual fase do CRISP-DM?
Alternativas
Q4346996 Estatística

Considerar o histograma abaixo e assinalar o valor correspondente a Q2 sinalizado pela seta:
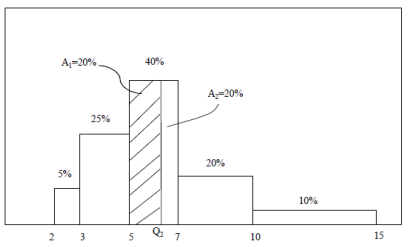


Imagem associada para resolução da questão

Alternativas
Q4346995 Estatística
Quando a relação linear entre variáveis resposta e preditoras for compatível com um modelo linear (no caso de uma relação polinomial, por exemplo), o uso de regressão linear é conveniente e obtemos modelos com interpretabilidade e poder preditivo satisfatórios. Uma forma de determinar se a regressão foi bem sucedida em explicar uma parcela significativa da variância de y é testar a hipótese nula de que a proporção da variabilidade de y explicada por x é igual a zero. Esse trabalho é realizado por meio do:
Alternativas
Q4346994 Banco de Dados
A Modelagem de Dados é um instrumento de grande importância na formatação de estruturas capazes de serem implantadas e compreendidas pelos Sistemas Gerenciadores de Banco de Dados. Analisar a sentença abaixo:

O Modelo multidimensional é uma técnica de modelagem conceitual de negócios, que facilita a investigação, o resumo e a organização de dados para a análise de negócios (1ª parte). O cubo é uma estrutura de dados multidimensional para analisar e recuperar dados (2ª parte). As hierarquias em dimensões e fórmulas são de primeira classe, ou seja, um cubo não duplica suas definições, o cubo pode ter qualquer n dimensões, também denotado de hipercubo ao invés de cubo, sendo que uma coleção de cubos é relacionada ao banco de dados multidimensional ou armazém de dados (Data Warehouse) multidimensional (3ª parte).

A sentença está:

Alternativas
Respostas
10641: B
10642: D
10643: C
10644: B
10645: C
10646: E
10647: D
10648: C
10649: A
10650: B
10651: E
10652: E
10653: C
10654: B
10655: A
10656: D
10657: E
10658: A
10659: C
10660: A