Questões de Concurso
Para fgv
Foram encontradas 153.900 questões
Resolva questões gratuitamente!
Junte-se a mais de 4 milhões de concurseiros!


Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782912
Banco de Dados
A adoção de modelos de bancos de dados NoSQL permite lidar
com grandes volumes de informações heterogêneas, estruturadas
e não estruturadas, oferecendo agilidade analítica e suporte à
tomada
de
decisão
baseada
em
evidências.
Sobre modelos de dados NoSQL orientados a documentos, grafos,
chave-valor e colunar, assinale a opção correta.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782911
Algoritmos e Estrutura de Dados
Técnicas de indexação baseadas em hashing permitem a
localização direta e eficiente de informações em tempo quase real,
otimizando o acesso a grandes volumes de registros produzidos
por câmeras, sensores e outros equipamentos de segurança
pública.
Sobre técnicas de indexação utilizando hashing, assinale a opção correta.
Sobre técnicas de indexação utilizando hashing, assinale a opção correta.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782910
Banco de Dados
Em uma arquitetura de data lake, cada lago de dados (data pond)
exerce uma função específica na maturação da informação. Essa
estrutura permite armazenar e tratar grandes volumes de dados
heterogêneos, provenientes de aplicações e tecnologias de gestão
de segurança pública municipal.
Considerando as características das camadas de um data pond, é correto afirmar que a camada
Considerando as características das camadas de um data pond, é correto afirmar que a camada
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782909
Segurança e Transporte
A análise de grandes volumes de dados provenientes, por
exemplo, de câmeras, sensores, ocorrências, registros
administrativos e redes sociais exige uma infraestrutura capaz de
processar informações de forma rápida e distribuída. Nesse
cenário, o MapReduce e Hadoop desempenham papel estratégico.
Eles permitem que órgãos municipais transformem dados brutos
em inteligência operacional, apoiando decisões em tempo real e o
planejamento preventivo das ações de segurança.
Em relação à abordagem desses conceitos, assinale a opção correta.
Em relação à abordagem desses conceitos, assinale a opção correta.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782908
Arquitetura de Software
A arquitetura Lambda oferece uma base tecnológica estratégica
para integrar, processar e analisar grandes volumes de dados
provenientes de fontes heterogêneas. Ao combinar formas
distintas de processamento, essa arquitetura viabiliza uma
inteligência situacional contínua, fortalecendo a tomada de
decisão baseada em evidências e a interoperabilidade entre os
órgãos municipais.
Das camadas disponíveis na arquitetura lambda, é correto afirmar que a camada de
Das camadas disponíveis na arquitetura lambda, é correto afirmar que a camada de
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782907
Segurança da Informação
A interoperabilidade entre sistemas como os da Guarda Municipal,
CET-Rio, Defesa Civil e COR-Rio pode se beneficiar de padrões de
federação de identidade para a gestão de identidade e acesso
(IAM).
Nesse contexto, e referente aos padrões SAML 2.0, Liberty Identity Web Services Framework (ID-WSF) e OpenID, é correto afirmar que
Nesse contexto, e referente aos padrões SAML 2.0, Liberty Identity Web Services Framework (ID-WSF) e OpenID, é correto afirmar que
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782906
Direito Digital
A Lei Geral de Proteção de Dados Pessoais (Lei nº 13.709/2018)
disciplina, no Capítulo II, as hipóteses em que é permitido o
tratamento de dados sensíveis sem o consentimento do titular. No
entanto, também estabelece limites claros quanto a usos
indevidos desses dados.
Considerando-se exclusivamente o texto da LGPD, assinale a opção que descreve uma situação expressamente proibida pela lei
Considerando-se exclusivamente o texto da LGPD, assinale a opção que descreve uma situação expressamente proibida pela lei
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782905
Banco de Dados
Em uma metrópole complexa como o Rio de Janeiro, o gestor de
segurança potencializa a qualidade de seu trabalho dispondo de
informações integradas e confiáveis para planejar ações
preventivas, otimizar recursos e responder rapidamente a
incidentes. O conceito de tidy data pode facilitar a análise de
dados, produzindo evidências analíticas consistentes para
embasar decisões estratégicas e políticas públicas de segurança.
Assinale a opção que descreve corretamente a estrutura de um conjunto de dados organizado segundo o conceito de tidy data.
Assinale a opção que descreve corretamente a estrutura de um conjunto de dados organizado segundo o conceito de tidy data.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782904
Estatística
Ao desenhar um plano amostral, é possível escolher diferentes
técnicas de amostragem. Sobre as características das técnicas de
amostragem, avalie as afirmações abaixo
I. Ao realizar um plano amostral por conglomerados em um estágio, pode-se fazer alocação uniforme, proporcional ou ótima.
II. Em um plano amostral estratificado, a variância da alocação ótima é menor ou igual à variância da alocação proporcional.
III. Ao selecionar o tamanho de uma amostra aleatória simples para estimar uma proporção, o intervalo conservador considera que p = 0,5.
Está correto o que se afirma em
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782903
Estatística
No contexto de dados em painel, a escolha fundamental entre o
modelo de Efeitos Fixos (EF) e o modelo de Efeitos Aleatórios (EA)
baseia-se primariamente em
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782902
Estatística
Uma empresa de segurança patrimonial deseja estimar a média de
ocorrências de incidentes de segurança por unidade (como
invasões, furtos ou falhas de acesso) em suas instalações
espalhadas pelo país. Para isso, será realizada uma amostra
aleatória simples (AAS) das unidades. Sabe-se, a partir de
levantamentos anteriores, que a variância populacional do
número de incidentes por unidade é igual a 10. A empresa deseja
que a margem de erro da estimativa da média, ao nível de
confiança de 95%, não ultrapasse 0,2 incidentes.
Sabendo que existem 1.000.000 de unidades sob gestão da empresa, o tamanho mínimo da amostra deve ser
Sabendo que existem 1.000.000 de unidades sob gestão da empresa, o tamanho mínimo da amostra deve ser
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782901
Estatística
Sobre os conceitos de correlação e análise de associação causal,
assinale a opção correta.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782900
Estatística
Durante uma análise de regressão sobre o impacto de treinamento
em incidentes de segurança, um único funcionário apresentou um
número de incidentes muito acima do padrão. O pesquisador
observou que o coeficiente da variável “horas de treinamento”
mudou drasticamente quando esse funcionário foi removido da
amostra.
Esse comportamento indica que o ponto é
Esse comportamento indica que o ponto é
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782899
Estatística
Um pesquisador encontrou correlação positiva entre o número de
vigilantes em um bairro e o número de ocorrências registradas.
Entretanto, é sabido que bairros mais perigosos tendem a receber
mais vigilantes.
Nesse caso, a correlação observada é um exemplo de
Nesse caso, a correlação observada é um exemplo de
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782898
Gestão de Pessoas
Uma empresa de segurança corporativa deseja avaliar a eficácia de
um novo programa de treinamento para vigilantes. Para isso, 200
profissionais de segurança foram selecionados aleatoriamente.
Metade deles participou do novo treinamento, enquanto a outra
metade manteve o treinamento tradicional. Os avaliadores
responsáveis por medir o desempenho dos vigilantes em testes
práticos não sabiam qual grupo havia recebido o novo
treinamento. Após quatro semanas, o desempenho médio nos
testes de simulação foi comparado entre os dois grupos.
Com base na descrição, assinale a opção que caracteriza corretamente o delineamento do estudo.,
Com base na descrição, assinale a opção que caracteriza corretamente o delineamento do estudo.,
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782897
Administração Pública
Um gestor de segurança deseja saber quanto a taxa de incidentes
teria sido menor se um programa de treinamento tivesse sido
aplicado em todas as unidades.
Nesse contexto, o conceito que expressa essa comparação hipotética é
Nesse contexto, o conceito que expressa essa comparação hipotética é
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782896
Estatística
O número de ocorrências de um certo evento em t horas, segue
uma distribuição de Poisson com taxa de ocorrência λ por hora,
dada por
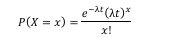
Com base nessas informações, indique o valor esperado do tempo entre duas ocorrências consecutivas deste evento.
Com base nessas informações, indique o valor esperado do tempo entre duas ocorrências consecutivas deste evento.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782895
Estatística
Ao longo da semana, de segunda a sexta-feira, registrou-se o número de ocorrências atendidas pela equipe de vigilância obtendo o seguinte conjunto de dados: 2,2,2,3,5
Assinale a opção correta quanto às medidas de resumo do conjunto apresentado.
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782894
Estatística
Os algoritmos de Monte Carlo via Cadeias de Markov (MCMC) são amplamente utilizados na modelagem bayesiana com o objetivo de obter amostras da distribuição a posteriori das quantidades de interesse. Dois exemplos de algoritmos nesta classe são os chamados Gibbs Sampling e Metropolis-Hastings.
Sobre estes algoritmos,é correto afirmar que
Ano: 2025
Banca:
FGV
Órgão:
Prefeitura de Rio de Janeiro - RJ
Prova:
FGV - 2025 - Prefeitura de Rio de Janeiro - RJ - Gestor de Segurança Municipal |
Q3782893
Estatística
Os testes de hipóteses são ferramentas importantes para tomada
de decisão com base em evidências estatísticas. Sobre estas
ferramentas, avalie as afirmações a seguir.
I. O nível de significância alfa representa a probabilidade de ocorrência do erro do tipo I. Isto é, rejeitar a hipótese nula quando esta é verdadeira.
II. Em um teste com p-valor igual a 2% e um nível de significância de 5%, não rejeitamos a hipótese nula.
III. O teste t-student é um teste utilizado para medir associação entre variáveis categóricas.
Está correto o que se afirma em

 Conheça nossos planos