Questões de Concurso Público IF-PI 2026 para Estatístico
Foram encontradas 50 questões


Com base nas propriedades clássicas do modelo de regressão linear, assinale a ÚNICA alternativa INCORRETA.
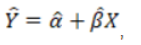
em que a variável dependente (Y) é o peso da criança ao nascer, medido em quilogramas (kg) e a variável independente (X) é o número de consultas de pré-natal realizadas durante a gestação.
O estatístico coletou uma amostra aleatória de n = 30 prontuários médicos e organizou a seguinte tabela com os somatórios dos dados para a estimação dos parâmetros pelo método dos Mínimos Quadrados Ordinários (MQO):
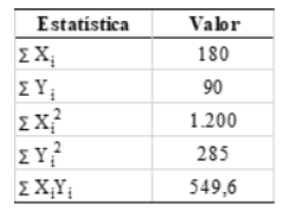
Com base nos resultados estimados pelo modelo, assinale a alternativa que apresenta a diferença esperada no peso ao nascer de uma criança cuja mãe realizou 8 consultas de pré-natal em comparação com uma criança cuja mãe realizou apenas 2 consultas.
Na etapa de diagnóstico de um modelo de regressão linear, a análise gráfica dos resíduos permite verificar a validade dos pressupostos do modelo.
Assinale a alternativa que apresenta o gráfico de resíduos característico de uma violação da suposição de homocedasticidade.
A respeito das propriedades e características dos métodos de agrupamento, analise as afirmativas de I a VI abaixo:
I. O método K-means é classificado como um método de agrupamento hierárquico e tem como principal vantagem a dispensa da definição prévia do número de grupos (clusters) pelo pesquisador.
II. O método do vizinho mais próximo (ou ligação simples) define a distância entre dois agrupamentos como a distância mínima entre qualquer par de observações, um de cada agrupamento, sendo altamente suscetível ao efeito de encadeamento (chaining).
III. O método do vizinho mais distante (ou ligação completa) calcula a distância entre os grupos considerando a distância máxima entre os seus pontos, o que tende a produzir agrupamentos mais compactos e de tamanhos similares.
IV. No método do centroide, a distância entre dois clusters é a distância entre as médias das observações de cada grupo. Uma de suas vantagens é a garantia matemática de que o dendrograma nunca apresentará inversões (reversões).
V. O algoritmo K-means funciona iterativamente para minimizar a variância intragrupo, contudo é bastante sensível à presença de outliers (valores atípicos), que podem deslocar drasticamente a posição dos centroides.
VI. Os métodos do vizinho mais próximo, vizinho mais distante e centroide são algoritmos hierárquicos aglomerativos, enquanto o K-means é essencialmente um método de partição nãohierárquico.
Assinale a ÚNICA alternativa que apresenta todos os itens CORRETOS.
Sabendo disso, responda às questões 45 e 46. Considerando a necessidade de elaborar um banco de dados para avaliar as políticas de permanência do IFPI, bem como os princípios de integração e interoperabilidade de dados institucionais, qual procedimento é o mais adequado?
I. No Bagging, cada árvore é construída por meio de amostra aleatória com reposição, considerando os dados de treinamento. Para cada árvore, a amostra tem tamanho igual à da base original, embora nem todas as observações originais estejam necessariamente representadas em cada árvore.
II. O uso de Feature Randomness busca aumentar a diversidade entre as árvores, restringindo aleatoriamente o conjunto de variáveis candidatas. Essa estratégia pode reduzir a correlação entre as árvores e contribuir para melhorar a capacidade de generalização da floresta.
III. Como o erro de generalização do Random Forest converge à medida que o número de árvores aumenta, a inclusão sucessiva de árvores garante que esse erro se aproxime de zero, desde que seja utilizado um número suficientemente grande de estimadores.
IV. Em problemas de classificação, Entropia e Impureza de Gini podem ser utilizadas como critérios para avaliar divisões (splits). Em problemas de regressão, MSE e MAE podem ser utilizados, sendo o MAE relativamente mais sensível a erros de grande magnitude.
Considerando exclusivamente os princípios apresentados sobre Random Forest, estão CORRETAS:
I. O aumento do número de neurônios em uma rede composta exclusivamente por transformações lineares é suficiente para que a rede represente relações não lineares suficientemente complexas, desde que a camada oculta possua quantidade elevada de neurônios.
II. A introdução de funções de ativação não lineares aumenta a capacidade representacional das redes neurais, mas também torna mais difícil sua otimização, pois a função de custo pode passar a apresentar estrutura não convexa.
III. Em redes neurais profundas, as camadas ocultas podem ser interpretadas como responsáveis pela construção de novas representações dos dados, de modo que camadas distintas podem aprender características em diferentes níveis de abstração.
IV. Como redes neurais possuem elevada capacidade de representação, o aumento do número de neurônios reduz simultaneamente o erro de treinamento e a possibilidade de sobreajuste, razão pela qual redes maiores tendem necessariamente a apresentar melhor capacidade de generalização.
Assinale a alternativa que apresenta as afirmativas CORRETAS.
Qual a probabilidade de, selecionado aleatoriamente, ser escolhido um estudante do Campus Dirceu, sabendo que o estudante tem necessidades específicas?
Considerando os aspectos teóricos do processo de estimação, analise as alternativas a seguir:
I. O Método dos Momentos produz necessariamente estimadores não viesados, pois a igualdade entre momentos populacionais e amostrais garante que a esperança matemática do estimador obtido seja exatamente igual ao parâmetro populacional correspondente.
II. Um estimador de máxima verossimilhança pode ser viesado em amostras finitas e, simultaneamente, ser consistente e assintoticamente eficiente, não havendo contradição entre essas propriedades.
III. A eficiência assintótica dos estimadores de máxima verossimilhança, sob condições regulares, está relacionada à Informação de Fisher e ao limite de Cramér-Rao; essa noção é conceitualmente mais ampla do que a propriedade Best Linear Unbiesed Estimation, pois não se restringe exclusivamente à classe dos estimadores lineares não viesados.
IV. A coincidência entre o estimador de máxima verossimilhança e o estimador obtido pelo Método dos Momentos em determinada distribuição permite concluir que ambos os métodos são teoricamente equivalentes para qualquer distribuição pertencente à mesma família paramétrica.
Assinale a alternativa que apresenta apenas as afirmativas INCORRETA.

 Conheça nossos planos