Questões de Concurso
Para analista de sistemas
Foram encontradas 18.421 questões
Resolva questões gratuitamente!
Junte-se a mais de 4 milhões de concurseiros!


Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771800
Algoritmos e Estrutura de Dados
O algoritmo abaixo contém a função FNC21(X).
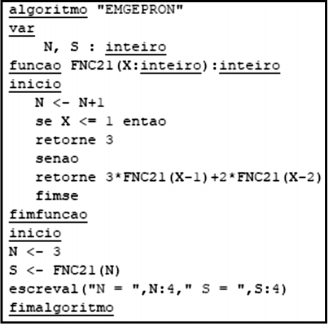
Após a execução, as variáveis N e S mostrarão, respectivamente, os seguintes valores:
Após a execução, as variáveis N e S mostrarão, respectivamente, os seguintes valores:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771799
Algoritmos e Estrutura de Dados
A figura mostra um algoritmo para realizar a
troca de valores entre duas variáveis: primeiro por
meio do auxílio da variável TOCA e, em seguida,
sem essa variável.
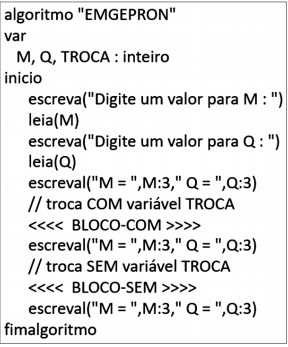
Os blocos de instruções que devem substituir as referências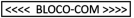 e
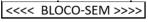 são, respectivamente:
Os blocos de instruções que devem substituir as referências
e são, respectivamente:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771798
Algoritmos e Estrutura de Dados
O pseudocódigo abaixo refere-se a um algoritmo conhecido por Triângulo de Pascal.
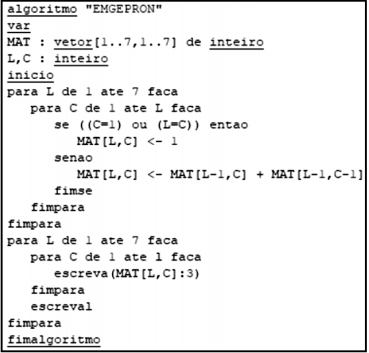
O resultado impresso, gerado pelo algoritmo, está
indicado na seguinte alternativa:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771797
Administração Geral
O Sistema de Gestão Integrada é um conjunto
de partes interagentes e interdependentes que,
conjuntamente, forma um todo unitário com objetivo
determinado e realiza sua função com eficiência,
alcançando resultados concretos. Os sistemas de
gestão têm por objetivo prover as organizações de
elementos de um modelo de gestão eficaz que possa
ser integrado a outros requisitos da gestão. Esse fator
de integração é o ponto chave na gestão da
organização. As estruturas das normas de gestão são
semelhantes e fundem-se num único modelo de
gestão. As normas de gestão seguem a estruturação
do modelo baseado no ciclo PDCA, uma ferramenta
que traz uma sequência de passos que auxiliam no
controle de qualidade da sua empresa, além de
auxiliar na organização de um projeto ou processo
que precisa ser melhorado. Nesse sentido, são
afirmativas que correspondem às etapas do ciclo:
I. corrigir o que deu errado e promover melhorias no processo II. estabelecer metas e definir como o processo será executado III. verificar se os resultados foram alcançados conforme o planejado IV. ocorrência da ação, na qual a equipe implementará o que foi planejado
As afirmativas em I, II, III e IV estão direta e respectivamente associadas a:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771796
Banco de Dados
Em bancos de dados relacionais, para obter
uma nova tabela ordenada ascendente por CODIGO
a partir de uma tabela FUNCIONARIOS, deve-se
utilizar o seguinte comando SQL:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771795
Engenharia de Software
No desenvolvimento de software, o início para
toda a atividade parte do levantamento de requisitos,
sendo repetida em todas as demais etapas da
engenharia de requisitos. Sommerville propõe um
processo genérico de levantamento e análise que
contém diversas atividades, sendo três delas
detalhadas a seguir.
I. É o processo de interagir com os stakeholders do sistema para descobrir seus requisitos, e a compreensão do domínio se desenvolve mais durante essa atividade. II. É um estágio que envolve interação com os stakeholders para a definição dos requisitos mais importantes, considerando que, em qualquer conjunto de requisitos, alguns serão mais importantes do que outros. III. É o processo que realiza uma análise dos requisitos para descobrir se estão completos e consistentes e se estão em concordância com o que os stakeholders desejam do sistema.
As atividades detalhas em I, II e III são conhecidas, respectivamente, como:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771794
Engenharia de Software
Um processo de desenvolvimento de software
pode ser visto como um conjunto de fases
organizadas, usadas para definir, desenvolver, testar
e manter um software. Existem diversos processos,
cabendo destacar que há algumas fases básicas
comuns à grande parte dos existentes. Em uma
dessas fases, o sistema é codificado a partir da
descrição computacional da fase de projeto em uma
outra linguagem, onde se torna possível a compilação
e geração do código - executável para o
desenvolvimento software. Em um processo de
desenvolvimento orientado a objetos, essa etapa
ocorre definindo as classes de objetos do sistema em
questão, fazendo uso das linguagens de
programação. Pode-se também utilizar ferramentas
de software e bibliotecas de classes preexistentes
para agilizar a atividade, como também o uso de
ferramentas CASE, que dinamizam o processo de
desenvolvimento, nas várias atividades, onde inclui-se geração de código-fonte e documentação.
Essa fase é denominada:
Essa fase é denominada:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771793
Banco de Dados
Ao iniciar o desenvolvimento de um novo
sistema, um dos primeiros passos a ser executado é o
estudo e levantamento dos requisitos necessários
para a construção do produto final. A partir das
informações obtidas, desenvolve-se um modelo
conceitual que será utilizado para orientar o
desenvolvimento propriamente dito, fornecendo
informações sobre os aspectos relacionados ao
domínio do projeto em questão. Esse modelo é
baseado na percepção do mundo real, consistindo de
um conjunto de objetos, elaborado para facilitar o
projeto do banco de dados, possibilitando especificar
a estrutura lógica geral do BD. A figura abaixo ilustra esse modelo conceitual,
empregado na Engenharia de Software para
descrever os objetos envolvidos em um domínio de
negócios, com seus atributos e como eles se
relacionam entre si.

Essa figura representa uma ferramenta conhecida por Modelo ou Diagrama:
Essa figura representa uma ferramenta conhecida por Modelo ou Diagrama:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771792
Banco de Dados
Na implementação de bancos de dados
relacionais, busca-se solucionar ou minimizar dois
problemas, descritos a seguir.
I. Está associado à ocorrência de informações armazenadas em arquivos separados, com conteúdos diferentes. II. Está associado à existência das mesmas informações em aplicações diferentes, como por exemplo, em arquivos de material e de registros de projetos.
As descrições em I e em II referem- se, respectivamente, aos seguintes termos:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Desenvolvimento de Sistemas) |
Q1771791
Engenharia de Software
No contexto da Análise e Projeto de Sistemas e
do processo de desenvolvimento de software, a UML
reconhece três tipos mais importantes de relações,
conceituadas a seguir.
I. São relacionamentos estruturais entre instâncias e especificam que objetos de uma classe estão ligados a objetos de outras classes, podendo existir entre classes ou entre objetos. II. São relacionamentos de utilização no qual uma mudança na especificação de um elemento pode alterar a especificação do elemento dependente. Este tipo de relação entre classes indica que os objetos de uma classe usam serviços dos objetos de outra classe. III. São relacionamentos entre um elemento mais geral e um mais específico. O elemento mais específico herda as propriedades e métodos do elemento mais geral. Este tipo de relação é também conhecida como herança no modelo a objetos, existindo só entre as classes.
Os tipos descritos em l, ll e lll são, respectivamente:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771450
Banco de Dados
No que diz respeito à mineração de dados, Data
Mining é um processo para explorar grandes
quantidades de dados à procura de padrões
consistentes, visando transformar dados em
informações úteis, e que utiliza diversas técnicas de
análise e mineração de dados, das quais três são
caracterizadas a seguir.
I. É direcionada ao agrupamento de dados, com base em um critério de identificação de dados semelhantes, fundamental para a seleção de grupos e posterior geração de insights. II. São utilizadas com mais frequência nos estágios iniciais do processo de Data Mining que servem para modelar relações entre os dados que entram e saem do processo de mineração. Por meio do uso de algoritmos, podem reconhecer padrões escondidos e correlações em dados brutos, agrupá-los e classificá-los e, com o tempo, aprender e melhorar continuamente. III. É uma ferramenta para ajudar uma pessoa, ou um grupo de pessoas, a tomarem uma decisão ao visualizar as suas ramificações e consequências. É uma ferramenta de suporte bastante útil para orientar discussões e guiar um grupo na resolução de um problema ou, até mesmo, na elaboração de um plano de ação. É de fácil interpretação dos dados e mostra o caminho a ser percorrido para alcançar determinado objetivo.
Essas técnicas em I, II e III, são conhecidas, respectivamente, como:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771449
Banco de Dados
No que diz respeito à manipulação de dados em
bancos de dados relacionais, Stored Procedure é um
bloco de código PL/SQL armazenado no servidor
com as seguintes características:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771448
Algoritmos e Estrutura de Dados
As figuras mostram em (I) um algoritmo que
gera uma sequência de números, usando a estrutura
de controle para... faca e em (II) o resultado da
execução.
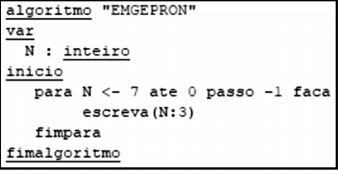 (I)
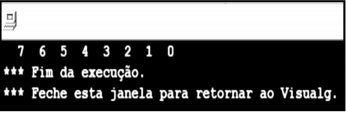 (II)
Duas estruturas equivalentes a para ... faca ... fimpara, que geram o mesmo resultado, a primeiro usando repita ... ate que... e a segunda enquanto... faca..., são mostradas, respectivamente, na seguinte opção:
(I) (II) Duas estruturas equivalentes a para ... faca ... fimpara, que geram o mesmo resultado, a primeiro usando repita ... ate que... e a segunda enquanto... faca..., são mostradas, respectivamente, na seguinte opção:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771447
Engenharia de Software
A modelagem de dados e os conceitos classes e
pacotes estão diretamente relacionados na
metodologia UML, uma tecnologia que se presta à
modelagem de estruturas que irão compor uma
aplicação, estando fortemente amparada em
conceitos de Orientação a Objetos. Os diferentes
diagramas que compõem a UML podem ser
agrupados em categorias, levando em consideração
o contexto do sistema em desenvolvimento. Entre os
diagramas, dois são caracterizados a seguir.
I. São diagramas estruturais que fornecem uma visão clara da estrutura hierárquica dos variados elementos UML dentro de um determinado sistema, sendo usados para mostrar a organização e disposição de vários elementos de modelos, onde cada elemento é representado como uma pasta de arquivo dentro do diagrama, e depois organizado hierarquicamente no diagrama. São bastante usados para proporcionar uma organização visual de uma arquitetura em camadas de qualquer classificador UML, por exemplo, um sistema de software. II. São diagramas que permitem a visualização de um conjunto de classes, detalhando atributos e operações, assim como prováveis relacionamentos entre as estruturas, possibilitando ainda as definições de interfaces. Ilustra graficamente como será a estrutura do software, em nível micro ou macro e como cada um dos componentes da sua estrutura estarão interligados.
As ferramentas caracterizadas em I e em II são denominados diagramas de:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771446
Engenharia de Software
O conceito que está diretamente associado ao
termo software livre é:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771445
Banco de Dados
A SQL oferece a possibilidade de uso de uma
cláusula no comando SELECT para eliminar
repetições em consultas, considerando as colunas
informadas na listagem de colunas do comando
SELECT que contenham valores iguais como o
mesmo registro. Considere o caso descrito a seguir.
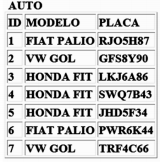
A figura refere-se a uma tabela AUTO de um banco de dados relacional. Para saber as marcas de automóveis envolvidas nesse caso, foi utilizada uma query SQL, que retorna essas marcas, sem repetição, indicada na
tabela SAIDA -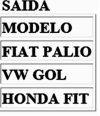 .
O comando SQL empregado foi:
A figura refere-se a uma tabela AUTO de um banco de dados relacional. Para saber as marcas de automóveis envolvidas nesse caso, foi utilizada uma query SQL, que retorna essas marcas, sem repetição, indicada na
tabela SAIDA -
. O comando SQL empregado foi:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771444
Banco de Dados
No que concerne à arquitetura de sistemas de
bancos de dados Oracle, existem diversos termos
específicos, siglas e nomes de serviços e aplicações.
Entre estes termos, dois são descritos a seguir.
I. Arquivos físicos de log que permitem a recuperação da instância do banco de dados. Esses arquivos contêm um registro de todas as alterações feitas nos dados nas tabelas e índices do banco, assim como mudanças realizadas na estrutura do banco de dados em si. A instância pode recuperar o banco com as informações contidas nesses arquivos – se os datafiles não forem perdidos. II. Área da SGA que armazena dados como declarações SQL executadas, cópias do dicionário de dados do banco e cache de resultados de consultas SQL e PL/SQL para reuso. Também contém dados das tabelas de sistema, como informações do conjunto de caracteres e informações de segurança.
Os termos descritos em I e em II são denominados, respectivamente:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771443
Banco de Dados
No que diz respeito à análise das informações e
tomada de decisões, um termo possui as
características listadas a seguir.
É um sistema utilizado para armazenar dados, de uma maneira organizada.
Pode guardar informações relativas às atividades de uma organização em bancos de dados, de forma consolidada. O desenho da base de dados favorece os relatórios, a análise de grandes volumes de dados e a obtenção de informações estratégicas que podem facilitar a tomada de decisão.
Centraliza e consolida grandes quantidades de dados de várias fontes. Seus recursos analíticos permitem que as organizações obtenham informações de negócios úteis de seus dados para melhorar a tomada de decisões.
Esse termo é conhecido como:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771442
Segurança da Informação
No contexto dos métodos criptográficos, a
assinatura digital permite comprovar dois aspectos
da segurança da informação: a primeira que qualifica
se a informação é documentada ou certificada como
verdadeira ou certa e a segunda que qualifica se uma
informação não foi alterada de forma não autorizada
ou indevida. A assinatura digital baseia-se no fato de
que apenas o dono conhece a chave privada e que,
se ela foi usada para codificar uma informação, então
apenas seu dono poderia ter feito isto. A verificação
da assinatura é feita com o uso da chave pública, pois
se o texto foi codificado com a chave privada,
somente a chave pública correspondente pode
decodificá-lo. Os dois aspectos de segurança da informação
mencionados acima, são, respectivamente:
Ano: 2021
Banca:
SELECON
Órgão:
EMGEPRON
Prova:
SELECON - 2021 - EMGEPRON - Analista de Sistemas (Auditoria) |
Q1771441
Banco de Dados
A SQL é conhecida comercialmente como uma
“linguagem de consulta” padrão utilizada para
manipular bases de dados relacionais, possuindo
diversos recursos na definição da estrutura de dados
para modificação de dados no banco de dados e para
a especificação de restrições de segurança. A SQL
integra três sub-linguagens, descritas a seguir.
I. Suporta comandos para manipular dados, como select, insert, update e delete. II. Suporta comandos para supervisionar o acesso aos dados, como grant e revoke. III. Suporta comandos para criação de objetos e administração do banco de dados, como alter e drop.
As sub-linguagens descritas em I, II e III são, respectivamente:

 Conheça nossos planos