Questões de Concurso Sobre banco de dados relacionais em banco de dados

Foram encontradas 1.991 questões

Q4274270 Banco de Dados
Comparado ao modelo hierárquico de banco de dados, qual é a principal vantagem estrutural do modelo relacional adotado pela maioria dos SGBDs corporativos atuais?
Alternativas
Q4262536 Banco de Dados
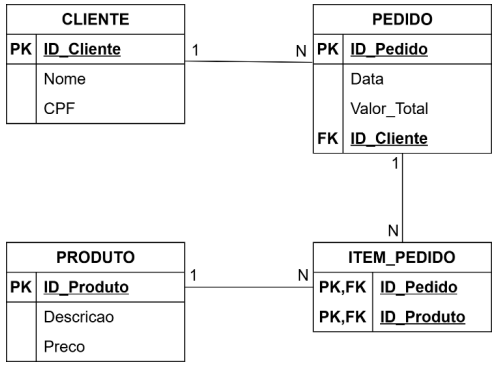
Considerando as tabelas CLIENTE (ID_Cliente, Nome) e PEDIDO (ID_Pedido, Data, ID_Cliente_FK) no diagrama lógico a seguir, um técnico precisa listar o ID_Pedido e a Data de todos os pedidos realizados por ‘João Silva’. Analise as opções abaixo e selecione a que apresenta a sintaxe correta para este filtro específico: 

q_39 t i.png (504×366)
Alternativas
Q4260135 Banco de Dados
Em um banco de dados de um sistema hospitalar, a tabela de consultas médicas possui uma coluna que armazena o identificador do médico responsável, criando um vínculo referencial com a tabela de médicos e impedindo o cadastro de consultas associadas a profissionais inexistentes no sistema. Assinale a alternativa correspondente ao mecanismo SQL responsável por essa restrição.
Alternativas
Q4259170 Banco de Dados
 No PostgreSQL, o planejador de consultas (Query Planner) decide a estratégia de acesso aos dados com base em estatísticas e custos estimados. Sobre as operações de Sequential Scan e Index Scan, assinale a alternativa CORRETA.
Alternativas
Q4259169 Banco de Dados
Considere as tabelas Funcionarios e Departamentos em um banco de dados relacional. A tabela Funcionarios possui uma coluna id_depto que faz referência à tabela Departamentos, mas alguns funcionários podem ainda não estar alocados em um departamento (valor NULL).

SELECT Funcionarios.nome, Departamentos.nome_depto  FROM Funcionários LEFT OUTER JOIN Departamentos  ON Funcionarios.id_depto = Departamentos.id_depto;

Qual será o resultado da execução desse comando? 
Alternativas
Q4259121 Banco de Dados
Em banco de dados relacional, qual comando SQL é utilizado para remover permanentemente uma tabela e todos os seus dados?
Alternativas
Q4256892 Banco de Dados
Identifique abaixo as afirmativas verdadeiras ( V ) e falsas ( F ) sobre administração de bancos de dados, otimização de consultas e tuning de desempenho.
(  ) A criação de índices em colunas frequentemente utilizadas em cláusulas WHERE ou JOIN pode acelerar significativamente as consultas de leitura, mas geralmente impõe um custo adicional de processamento durante operações de inserção, atualização e exclusão (DML).
(  ) O plano de execução (execution plan) gerado pelo otimizador de consultas de um SGBDR detalha a estratégia física que será utilizada para recuperar os dados, como a escolha entre um table scan ou um index seek.
(  ) O particionamento de tabelas grandes é uma técnica de tuning que divide logicamente a tabela em partes menores gerenciáveis, melhorando o desempenho de consultas e facilitando operações de manutenção, como backups.
(  ) Em bancos de dados como PostgreSQL e MySQL, a desnormalização de tabelas é estritamente proibida pelo motor de armazenamento, pois viola as regras de integridade referencial do padrão ANSI SQL.
(  ) O isolamento de transações no nível “Read Uncommitted” previne o fenômeno conhecido como leitura suja (dirty read), garantindo que uma transação apenas acesse dados que já foram confirmados (committed) por outras transações.
Assinale a alternativa que indica a sequência correta, de cima para baixo.
Alternativas
Q4256891 Banco de Dados
A linguagem SQL (Structured Query Language) é o padrão para a manipulação e definição de dados em Sistemas de Gerenciamento de Bancos de Dados Relacionais (SGBDR). 
Assinale a alternativa correta em relação às operações de junção e funções de agregação.
Alternativas
Q4256890 Banco de Dados
A modelagem de dados no modelo relacional baseia-se em conceitos matemáticos para garantir a integridade e a organização das informações. 
Assinale a alternativa correta sobre o modelo relacional e o processo de normalização.
Alternativas
Q4255269 Banco de Dados
Uma equipe de análise de dados da Assembleia Legislativa mantém um banco de dados relacional contendo informações sobre parlamentares, proposições, comissões, votações e tramitações. Durante a elaboração de um estudo institucional, surgiu a necessidade de calcular a quantidade de proposições apresentadas por cada parlamentar, retornando apenas aqueles que possuíam pelo menos uma proposição cadastrada no período analisado. Para atender a esse requisito, os analistas decidiram utilizar mecanismos de agregação disponíveis na linguagem SQL.
Assinale a alternativa que apresenta uma interpretação tecnicamente adequada acerca do uso da cláusula GROUP BY em consultas SQL.
Alternativas
Q4255263 Banco de Dados
A área de análise de dados da Assembleia Legislativa mantém informações sobre proposições legislativas, parlamentares, votações e comissões em bancos de dados relacionais. Durante a elaboração de relatórios institucionais, tornou-se necessário recuperar apenas os registros que atendiam a critérios específicos, combinar informações provenientes de diferentes tabelas e produzir conjuntos de dados consolidados para posterior análise estatística. Nesse contexto, discutiu-se o papel da linguagem SQL nas atividades de ciência de dados.
Assinale a alternativa que apresenta uma interpretação tecnicamente adequada.
Alternativas
Q4255259 Banco de Dados
Uma equipe de análise de dados da Assembleia Legislativa está desenvolvendo uma plataforma unificada para consolidar informações provenientes de diferentes fontes institucionais. Entre os dados disponíveis encontram-se registros armazenados em bancos de dados relacionais, documentos legislativos em formato PDF, arquivos JSON obtidos por APIs, imagens digitalizadas de processos históricos e logs gerados por sistemas corporativos. Durante a fase de modelagem da solução, tornou-se necessário classificar adequadamente os diferentes tipos de dados para definir estratégias de armazenamento, integração e processamento.
Assinale a alternativa que apresenta uma classificação tecnicamente adequada dos tipos de dados utilizados nesse cenário.
Alternativas
Q4248447 Banco de Dados
        Em determinado banco de dados, a tabela SERVIDOR está relacionada à tabela DEPENDENTE via LEFT JOIN, e o resultado dessa operação é posteriormente relacionado à tabela PLANO_SAUDE via INNER JOIN, utilizando-se como chave o identificador do plano registrado na tabela DEPENDENTE.

A partir da situação hipotética apresentada, julgue o próximo item.


A utilização do LEFT JOIN como primeira instrução da consulta garante que todos os registros da tabela SERVIDOR sejam preservados no conjunto de resultados final, independentemente de haver ou não uma correspondência válida para o INNER JOIN subsequente entre as tabelas DEPENDENTE e PLANO_SAUDE.

Alternativas
Q4248446 Banco de Dados
        Em determinado banco de dados, a tabela SERVIDOR está relacionada à tabela DEPENDENTE via LEFT JOIN, e o resultado dessa operação é posteriormente relacionado à tabela PLANO_SAUDE via INNER JOIN, utilizando-se como chave o identificador do plano registrado na tabela DEPENDENTE.

A partir da situação hipotética apresentada, julgue o próximo item.


Considere que, para solucionar o problema de preservação de dados descrito na situação hipotética, tenha sido proposta a criação da view a seguir como alternativa. Nesse cenário, a view proposta é tecnicamente adequada para retornar com sucesso a listagem de todos os servidores e seus respectivos planos, uma vez que a subconsulta correlacionada isola a lógica de junção e impede o descarte de linhas da tabela principal. 
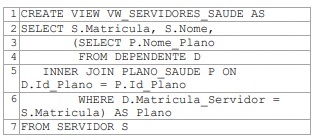

Imagem associada para resolução da questão

Alternativas
Q4248445 Banco de Dados

No que concerne à modelagem de dados relacional e à normalização, julgue o item que se segue.


Suponha que, na modelagem de dados de certa SEPLAG, haja as entidades Bem_Patrimonial (identificada por Num_Tombamento) e Unidade_Administrativa (identificada por Cod_Unidade). Nesse caso, se a regra de negócio determinar que cada movimentação de um bem entre unidades deva ser registrada com suas respectivas Data_Transferencia e Matricula_Responsavel, e receba um Numero_Protocolo exclusivo para que cada evento de transferência possa ser individualmente referenciado por outros processos do sistema, a implementação correta desse cenário no modelo lógico dar-se-á por meio de uma entidade associativa com identificador próprio.

Alternativas
Q4248444 Banco de Dados

No que concerne à modelagem de dados relacional e à normalização, julgue o item que se segue.


Considere que, na base de dados de recursos humanos de uma organização, a tabela AVERBACAO_TEMPO seja definida pelo esquema AVERBACAO_TEMPO (ID_Averbacao, Matricula, Data_Inicio, Data_Fim, Total_Dias_Averbados), em que ID_Averbacao é a chave primária e Total_Dias_Averbados armazena o resultado da diferença entre as datas de término e início. Nesse caso, sob a ótica da teoria da normalização, a estrutura da tabela AVERBACAO_TEMPO viola a terceira forma normal (3FN) devido à existência de dependência funcional transitiva entre atributos não chave.

Alternativas
Q4248443 Banco de Dados

Em relação ao modelo relacional de bancos de dados, julgue o item subsequente.


A restrição de integridade referencial entre duas tabelas não é violada quando a chave estrangeira contém um valor nulo, indicando a ausência de associação, desde que tal atributo não faça parte da chave primária da relação referenciadora, caso em que o valor nulo seria vedado pela restrição de integridade de entidade.

Alternativas
Q4246528 Banco de Dados
Relacione a Coluna 1 à Coluna 2, associando cada comando SQL à sua finalidade.

Coluna 1
1. CREATE TABLE.
2. INSERT INTO.
3. UPDATE.
4. DROP TABLE.

Coluna 2
( ) Modificar valores de registros existentes.
( ) Excluir permanentemente uma tabela e sua estrutura.
( ) Criar uma tabela no esquema do banco.
( ) Inserir novos registros em uma tabela existente.


A ordem correta de preenchimento dos parênteses, de cima para baixo, é: 
Alternativas
Q4244318 Banco de Dados
Considere uma tabela relacional PEDIDO projetada com a chave primária composta (id_pedido, id_produto) e os atributos não chave descricao_produto, quantidade e preco_unitario. Sobre os conceitos de dependência funcional e o processo de normalização aplicados a essa estrutura, analise as assertivas a seguir:

I. O atributo descricao_produto depende funcionalmente apenas de id_produto, caracterizando uma dependência parcial em relação à chave primária composta, o que viola a Segunda Forma Normal (2FN).
II. A criação de uma nova relação denominada PRODUTO, identificada pela chave primária id_produto e contendo o atributo descricao_produto, é o procedimento correto para eliminar a dependência parcial identificada.
III. O atributo quantidade deve ser removido da tabela PEDIDO durante o processo de normalização, pois apresenta dependência funcional exclusiva e direta em relação ao atributo id_produto.

Quais estão corretas?

Alternativas
Q4237468 Banco de Dados
No projeto de um banco de dados relacional, o processo de normalização de dados tem como objetivo conceitual e principal:
Alternativas
Respostas
41: D
42: B
43: C
44: B
45: C
46: D
47: A
48: D
49: E
50: B
51: E
52: A
53: E
54: E
55: C
56: C
57: C
58: A
59: C
60: B