Questões de Concurso Público DATAPREV 2026 para Analista de Tecnologia da Informação – Inteligência da Informação
Foram encontradas 70 questões


Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389043
Banco de Dados
Os bancos de dados NoSQL (Not Only SQL) ganharam popularidade
por sua capacidade de lidar com grandes volumes de dados não
estruturados ou semiestruturados. Eles são frequentemente
classificados em quatro categorias principais, com base no modelo
empregado para representar e organizar os dados.
Assinale a opção que apresenta corretamente essas quatro categorias.
Assinale a opção que apresenta corretamente essas quatro categorias.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389044
Banco de Dados
Considere a tabela Projeto_Engenheiro com a seguinte estrutura
de colunas: CodigoEngenheiro, CodigoProjeto, HorasAlocadas,
NomeEngenheiro e EspecialidadeEngenheiro.
Sabe-se que a chave primária da tabela é composta conjuntamente por (CodigoEngenheiro, CodigoProjeto). Ao analisar as dependências funcionais, verifica-se que NomeEngenheiro e EspecialidadeEngenheiro são funcionalmente determinados apenas por CodigoEngenheiro, que corresponde à parte da chave primária composta.
Assinale a opção que avalia corretamente a adequação dessa estrutura à 2ª Forma Normal (2FN).
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389045
Banco de Dados
Considere as tabelas Cliente e Pedido, em que Cliente.CodigoCliente é a chave primária, e Pedido.CodigoCliente é uma chave estrangeira que referencia essa coluna.
Analise as duas definições a seguir:
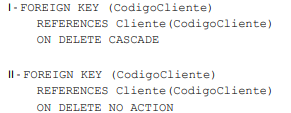
Assinale a opção que apresenta corretamente a diferença entre os comportamentos das duas definições.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389046
Banco de Dados
Uma organização possui um data warehouse, utilizado para
produzir indicadores financeiros a partir de dados provenientes de
diferentes sistemas operacionais.
Durante uma auditoria, a equipe responsável analisou algumas informações relacionadas ao ambiente.
I. A tabela FATO_VENDAS possui o atributo valor_liquido, definido como um número decimal com duas casas decimais, e esse atributo não pode receber valores nulos.
II. O indicador “venda líquida” representa o valor bruto das vendas após a dedução dos descontos e das devoluções, conforme a regra estabelecida pela organização.
III. O processo de carga da tabela FATO_VENDAS é executado diariamente às 2h. Na última execução, foram extraídos 1.253.428 registros, dos quais 1.251.936 foram carregados com sucesso.
Considerando as características dos metadados em ambientes de data warehouse, assinale a opção que apresenta a classificação correta das informações I, II e III, respectivamente.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389047
Banco de Dados
Considere um modelo dimensional destinado à análise de vendas,
composto pelas tabelas FatoVenda, DimProduto, DimCliente e
DimData.
A tabela FatoVenda possui as colunas: CodigoProduto, CodigoCliente, CodigoData, Quantidade e ValorVenda. As três primeiras colunas referenciam, respectivamente, as chaves das tabelas DimProduto, DimCliente e DimData.
Assinale a alternativa que contém a afirmação correta sobre a forma como os relacionamentos entre a tabela fato e as dimensões são materializados nesse modelo.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389048
Banco de Dados
Uma instituição pretende implantar uma aplicação projetada para
armazenar informações sobre itens pertencentes ao seu
patrimônio. Os itens pertencem a diferentes categorias e podem
apresentar conjuntos distintos de atributos.
Além disso, novos tipos de itens e novos atributos podem ser
incorporados frequentemente, sem que seja desejável modificar
continuamente a estrutura global do banco de dados.
A aplicação realizará principalmente operações de inserção,
consulta e atualização de itens completos, sendo conveniente
recuperar as informações de cada item como uma unidade de
dados.
Considerando essas características, assinale a opção que apresenta a abordagem de banco de dados mais adequada ao cenário descrito.
Considerando essas características, assinale a opção que apresenta a abordagem de banco de dados mais adequada ao cenário descrito.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389049
Banco de Dados
Considere o modelo relacional de uma transportadora composto
pelas tabelas Veiculo e Viagem.
A tabela Veiculo possui as colunas CodigoVeiculo (PK) e KmAtual,
contendo 50 veículos cadastrados. O atributo kmAtual aceita
valores nulos. Já a tabela Viagem possui as colunas CodigoViagem
(PK), CodigoVeiculo (FK) e KmFinal, contendo os registros de
viagens finalizadas. Sabe-se que apenas 30 desses veículos
possuem registros na tabela Viagem (os outros 20 são veículos
recém-adquiridos que nunca viajaram.
Um desenvolvedor executou a seguinte instrução SQL no banco de dados:
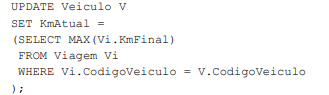
Assinale a opção que descreve corretamente o resultado da execução dessa instrução.
Um desenvolvedor executou a seguinte instrução SQL no banco de dados:
Assinale a opção que descreve corretamente o resultado da execução dessa instrução.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389050
Banco de Dados
A modelagem conceitual de bancos de dados é uma representação
abstrata do negócio que visa identificar as entidades envolvidas e
os relacionamentos entre elas.
No mapeamento de um relacionamento N:M identificado no modelo conceitual para o modelo relacional, deve-se
No mapeamento de um relacionamento N:M identificado no modelo conceitual para o modelo relacional, deve-se
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389051
Matemática
Em uma rotina diária de Extração, Transformação e Carga (ETL)
destinada à atualização de um Data Warehouse (DW) da
DATAPREV, são extraídos 120.000 registros de um sistema de
atendimento e 80.000 registros de um sistema de gestão de
serviços.
Durante a etapa de transformação, 10% do total de registros
extraídos são identificados como duplicados e eliminados. Em
seguida, 5% dos registros restantes são rejeitados por não
atenderem às regras de validação estabelecidas.
Dos registros válidos ao final dessas etapas, 30% correspondem a
registros já existentes no DW e são atualizados, enquanto os
demais são inseridos como novos registros.
O número de novos registros inseridos no Data Warehouse, ao final da execução do ETL, é de
O número de novos registros inseridos no Data Warehouse, ao final da execução do ETL, é de
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389052
Estatística
Na análise de 10.000 registros de incidentes de serviços de TIC da
DATAPREV, foi utilizada a técnica de regras de associação para
identificar ocorrências que aparecem conjuntamente nos
registros. A equipe deseja avaliar a regra A → B.
Dentre os registros, destacam-se:
• 2.000 incidentes apresentaram a ocorrência A;
• 1.500 incidentes apresentaram a ocorrência B; e
• 1.200 incidentes apresentaram simultaneamente as ocorrências A e B.
Considerando as métricas empregadas em regras de associação, os valores de suporte e confiança para a regra A → B são, respectivamente,
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389053
Matemática
No desenvolvimento de modelos de Aprendizado de Máquina, a
análise do espaço de hipóteses é importante para compreender a
capacidade de generalização de um modelo.
Acerca dos conceitos de viés (bias), variância (variance) e dos fenômenos de subajuste (underfitting) e sobreajuste (overfitting), analise os itens a seguir:
I. Um viés alto pode ser provocado por restrições estruturais no próprio espaço de hipóteses, induzindo ao subajuste do modelo.
II. Uma das causas de sobreajuste do modelo é uma variância alta, prejudicando seu desempenho em novos dados mesmo quando o desempenho no treinamento é satisfatório.
III. O compromisso viés-variância (bias-variance trade-off) estabelece um dilema entre optar por hipóteses mais complexas com baixo viés ou hipóteses mais simples com baixa variância.
Está correto o que se afirma em
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389054
Estatística
Um cientista de dados possui um conjunto de dados com
exatamente 1.500 amostras e decide avaliar seu modelo de
aprendizado de máquina utilizando a técnica de k-Fold CrossValidation (validação cruzada com k-repetições).
Considerando o funcionamento padrão dessa técnica, o número total de vezes em que o modelo será treinado e a quantidade exata de amostras utilizadas para treinamento em cada uma das rodadas (folds) de validação são, para k = 5, respectivamente,
Considerando o funcionamento padrão dessa técnica, o número total de vezes em que o modelo será treinado e a quantidade exata de amostras utilizadas para treinamento em cada uma das rodadas (folds) de validação são, para k = 5, respectivamente,
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389055
Algoritmos e Estrutura de Dados
Uma das métricas utilizadas no algoritmo K-NN (K-Nearest
Neighbors), no desenvolvimento de modelos de Aprendizado de
Máquina, é a distância de Minkowski, definida pela norma-p, onde
p é a ordem.
Nesse contexto, analise os itens a seguir.
I. Quando p = 1, a distância de Minkowski calcula o número de atributos diferentes entre dois vetores no espaço.
II. Quando p = 2, a distância de Minkowski calcula a distância euclidiana entre dois vetores no espaço.
III. Quando p = K, a distância de Minkowski calcula a distância média para os K vizinhos mais próximos.
Está correto o que se afirma em
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389056
Estatística
O problema da alta dimensionalidade, comum em modelos de
Aprendizado de Máquina, pode ser tratado com técnicas de
redução de dimensionalidade.
Sobre esse assunto, analise as afirmativas a seguir e assinale (V)
para a verdadeira e (F) para a falsa.
( ) A redução de dimensionalidade tem como principal objetivo escolher dados apenas do espaço bidimensional.
( ) As técnicas de agregação são aplicadas para descartar parte dos atributos originais por meio da criação de grupos de atributos.
( ) A técnica de Análise de Componentes Principais (Principal Component Analysis) permite eliminar redundâncias geradas pela alta correlação entre as variáveis originais.
As afirmativas são, respectivamente,
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389057
Estatística
O algoritmo K-Means (K-Médias, em português), usado em
Aprendizado de Máquina, pode ser descrito como um método
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389058
Estatística
No contexto do Aprendizado de Máquina não supervisionado, os
Modelos de Mistura Gaussiana (Gaussian Mixture Models)
representam uma abordagem probabilística para a tarefa de
agrupamento (clustering).
Acerca das características e do funcionamento dessa técnica, analise os itens a seguir. I. De acordo com a técnica, cada gaussiana no modelo de mistura possui três parâmetros principais: média, peso e matriz de covariância. II. O modelo calcula para cada instância a probabilidade de ela ter sido gerada por cada um dos componentes da mistura. III. Os agrupamentos gerados por essa técnica são matematicamente limitados a formatos esféricos, impossibilitando a modelagem de distribuições elípticas ou com volumes distintos no espaço de dados. Está correto o que se afirma em
Acerca das características e do funcionamento dessa técnica, analise os itens a seguir. I. De acordo com a técnica, cada gaussiana no modelo de mistura possui três parâmetros principais: média, peso e matriz de covariância. II. O modelo calcula para cada instância a probabilidade de ela ter sido gerada por cada um dos componentes da mistura. III. Os agrupamentos gerados por essa técnica são matematicamente limitados a formatos esféricos, impossibilitando a modelagem de distribuições elípticas ou com volumes distintos no espaço de dados. Está correto o que se afirma em
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389059
Algoritmos e Estrutura de Dados
A equipe de IA de uma FinTech foi encarregada de refatorar o
pipeline de treinamento da rede neural responsável pela detecção
de fraudes em transações de cartão de crédito. Atualmente, o
sistema processa cerca de 50 milhões de transações diárias. No
relatório técnico entregue à diretoria, os engenheiros precisam
justificar a escolha da arquitetura de treinamento, detalhando as
vantagens e o papel de cada algoritmo envolvido na otimização da
rede.
Considerando o funcionamento, a eficiência computacional e as vantagens comparativas dos algoritmos de otimização, assinale a afirmativa correta.
Considerando o funcionamento, a eficiência computacional e as vantagens comparativas dos algoritmos de otimização, assinale a afirmativa correta.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389060
Engenharia de Software
Uma equipe de Ciência de Dados construiu uma rede neural
profunda para prever a taxa de cancelamento de clientes em uma
grande plataforma. Durante a fase de validação, os engenheiros
notaram que o modelo apresentava uma acurácia próxima de 99%
no conjunto de dados de treino, mas o desempenho despencava
para 62% no conjunto de testes. Para combater esse problema de
sobreajuste, a liderança técnica solicitou a aplicação de técnicas de
regularização baseadas na penalização da função de perda por
meio de normas (L1 e L2), visando melhorar a capacidade de
generalização do modelo e limitar o crescimento excessivo dos
pesos.
Considerando o comportamento e o impacto teórico das penalizações pela norma L1 (Lasso) e pela norma L2 (Decaimento de Pesos) nas redes neurais artificiais, assinale a afirmativa correta.
Considerando o comportamento e o impacto teórico das penalizações pela norma L1 (Lasso) e pela norma L2 (Decaimento de Pesos) nas redes neurais artificiais, assinale a afirmativa correta.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389061
Noções de Informática
Um especialista foi contratado por uma multinacional do setor
logístico para desenvolver um sistema automatizado de inspeção
de qualidade. O objetivo é identificar pequenas fissuras e defeitos
superficiais em caixas de papelão que passam em alta velocidade
por uma esteira industrial.
Para resolver o problema, a equipe optou por utilizar uma Rede Neural Convolucional (CNN). Durante a etapa de arquitetura do modelo, os engenheiros precisam definir o papel de cada camada na extração de características.
Considerando o funcionamento interno de uma CNN aplicada a esse cenário industrial, assinale a afirmativa correta.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389062
Engenharia de Software
A equipe de Engenharia de Dados de uma multinacional está
otimizando o pipeline de PLN de um sistema de atendimento ao
cliente em tempo real. O objetivo é classificar os chamados
recebidos em categorias de urgência e encaminhá-los ao suporte
técnico correto.
Durante o desenvolvimento do modelo de inteligência artificial, os
engenheiros debateram sobre o impacto de diferentes técnicas de
pré-processamento e vetorização na captura do significado
semântico e contextual das mensagens dos usuários.
Considerando os conceitos fundamentais de pré-processamento, vetorização e arquitetura de PLN aplicados a esse cenário, assinale a afirmativa correta.
Considerando os conceitos fundamentais de pré-processamento, vetorização e arquitetura de PLN aplicados a esse cenário, assinale a afirmativa correta.

 Conheça nossos planos