Questões de Concurso Público DATAPREV 2026 para Analista de Tecnologia da Informação – Inteligência da Informação
Foram encontradas 9 questões


Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389043
Banco de Dados
Os bancos de dados NoSQL (Not Only SQL) ganharam popularidade
por sua capacidade de lidar com grandes volumes de dados não
estruturados ou semiestruturados. Eles são frequentemente
classificados em quatro categorias principais, com base no modelo
empregado para representar e organizar os dados.
Assinale a opção que apresenta corretamente essas quatro categorias.
Assinale a opção que apresenta corretamente essas quatro categorias.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389044
Banco de Dados
Considere a tabela Projeto_Engenheiro com a seguinte estrutura
de colunas: CodigoEngenheiro, CodigoProjeto, HorasAlocadas,
NomeEngenheiro e EspecialidadeEngenheiro.
Sabe-se que a chave primária da tabela é composta conjuntamente por (CodigoEngenheiro, CodigoProjeto). Ao analisar as dependências funcionais, verifica-se que NomeEngenheiro e EspecialidadeEngenheiro são funcionalmente determinados apenas por CodigoEngenheiro, que corresponde à parte da chave primária composta.
Assinale a opção que avalia corretamente a adequação dessa estrutura à 2ª Forma Normal (2FN).
Sabe-se que a chave primária da tabela é composta conjuntamente por (CodigoEngenheiro, CodigoProjeto). Ao analisar as dependências funcionais, verifica-se que NomeEngenheiro e EspecialidadeEngenheiro são funcionalmente determinados apenas por CodigoEngenheiro, que corresponde à parte da chave primária composta.
Assinale a opção que avalia corretamente a adequação dessa estrutura à 2ª Forma Normal (2FN).
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389045
Banco de Dados
Considere as tabelas Cliente e Pedido, em que Cliente.CodigoCliente é a chave primária, e Pedido.CodigoCliente é uma chave estrangeira que referencia essa coluna.
Analise as duas definições a seguir:
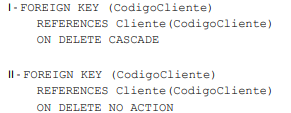
Assinale a opção que apresenta corretamente a diferença entre os comportamentos das duas definições.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389046
Banco de Dados
Uma organização possui um data warehouse, utilizado para
produzir indicadores financeiros a partir de dados provenientes de
diferentes sistemas operacionais.
Durante uma auditoria, a equipe responsável analisou algumas informações relacionadas ao ambiente.
I. A tabela FATO_VENDAS possui o atributo valor_liquido, definido como um número decimal com duas casas decimais, e esse atributo não pode receber valores nulos.
II. O indicador “venda líquida” representa o valor bruto das vendas após a dedução dos descontos e das devoluções, conforme a regra estabelecida pela organização.
III. O processo de carga da tabela FATO_VENDAS é executado diariamente às 2h. Na última execução, foram extraídos 1.253.428 registros, dos quais 1.251.936 foram carregados com sucesso.
Considerando as características dos metadados em ambientes de data warehouse, assinale a opção que apresenta a classificação correta das informações I, II e III, respectivamente.
Durante uma auditoria, a equipe responsável analisou algumas informações relacionadas ao ambiente.
I. A tabela FATO_VENDAS possui o atributo valor_liquido, definido como um número decimal com duas casas decimais, e esse atributo não pode receber valores nulos.
II. O indicador “venda líquida” representa o valor bruto das vendas após a dedução dos descontos e das devoluções, conforme a regra estabelecida pela organização.
III. O processo de carga da tabela FATO_VENDAS é executado diariamente às 2h. Na última execução, foram extraídos 1.253.428 registros, dos quais 1.251.936 foram carregados com sucesso.
Considerando as características dos metadados em ambientes de data warehouse, assinale a opção que apresenta a classificação correta das informações I, II e III, respectivamente.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389047
Banco de Dados
Considere um modelo dimensional destinado à análise de vendas,
composto pelas tabelas FatoVenda, DimProduto, DimCliente e
DimData.
A tabela FatoVenda possui as colunas: CodigoProduto, CodigoCliente, CodigoData, Quantidade e ValorVenda. As três primeiras colunas referenciam, respectivamente, as chaves das tabelas DimProduto, DimCliente e DimData.
Assinale a alternativa que contém a afirmação correta sobre a forma como os relacionamentos entre a tabela fato e as dimensões são materializados nesse modelo.
A tabela FatoVenda possui as colunas: CodigoProduto, CodigoCliente, CodigoData, Quantidade e ValorVenda. As três primeiras colunas referenciam, respectivamente, as chaves das tabelas DimProduto, DimCliente e DimData.
Assinale a alternativa que contém a afirmação correta sobre a forma como os relacionamentos entre a tabela fato e as dimensões são materializados nesse modelo.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389048
Banco de Dados
Uma instituição pretende implantar uma aplicação projetada para
armazenar informações sobre itens pertencentes ao seu
patrimônio. Os itens pertencem a diferentes categorias e podem
apresentar conjuntos distintos de atributos.
Além disso, novos tipos de itens e novos atributos podem ser
incorporados frequentemente, sem que seja desejável modificar
continuamente a estrutura global do banco de dados.
A aplicação realizará principalmente operações de inserção,
consulta e atualização de itens completos, sendo conveniente
recuperar as informações de cada item como uma unidade de
dados.
Considerando essas características, assinale a opção que apresenta a abordagem de banco de dados mais adequada ao cenário descrito.
Considerando essas características, assinale a opção que apresenta a abordagem de banco de dados mais adequada ao cenário descrito.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389049
Banco de Dados
Considere o modelo relacional de uma transportadora composto
pelas tabelas Veiculo e Viagem.
A tabela Veiculo possui as colunas CodigoVeiculo (PK) e KmAtual,
contendo 50 veículos cadastrados. O atributo kmAtual aceita
valores nulos. Já a tabela Viagem possui as colunas CodigoViagem
(PK), CodigoVeiculo (FK) e KmFinal, contendo os registros de
viagens finalizadas. Sabe-se que apenas 30 desses veículos
possuem registros na tabela Viagem (os outros 20 são veículos
recém-adquiridos que nunca viajaram.
Um desenvolvedor executou a seguinte instrução SQL no banco de dados:
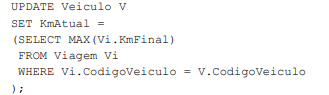
Assinale a opção que descreve corretamente o resultado da execução dessa instrução.
Um desenvolvedor executou a seguinte instrução SQL no banco de dados:
Assinale a opção que descreve corretamente o resultado da execução dessa instrução.
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389050
Banco de Dados
A modelagem conceitual de bancos de dados é uma representação
abstrata do negócio que visa identificar as entidades envolvidas e
os relacionamentos entre elas.
No mapeamento de um relacionamento N:M identificado no modelo conceitual para o modelo relacional, deve-se
No mapeamento de um relacionamento N:M identificado no modelo conceitual para o modelo relacional, deve-se
Ano: 2026
Banca:
FGV
Órgão:
DATAPREV
Prova:
FGV - 2026 - DATAPREV - Analista de Tecnologia da Informação – Inteligência da Informação |
Q4389066
Banco de Dados
No âmbito das tecnologias para Big Data, o Apache Hadoop e o
Apache Spark apresentam características distintas de execução e
tolerância a falhas.
Analise as afirmativas a seguir e assinale (V) para a verdadeira e (F) para a falsa.
( ) O Hadoop MapReduce grava dados intermediários em disco entre as fases de Map e Reduce, enquanto o Spark processa e retém dados preferencialmente na memória RAM.
( ) No Apache Spark, as transformações disparam imediatamente a computação física no cluster, enquanto as ações apenas registram as etapas no Grafo Acíclico Dirigido (DAG).
( ) A tolerância a falhas no HDFS ocorre pela replicação de blocos em múltiplos nós, enquanto no Spark ela se baseia no histórico de linhagem (lineage) para reconstituir partições perdidas.
As afirmativas são, respectivamente,
Analise as afirmativas a seguir e assinale (V) para a verdadeira e (F) para a falsa.
( ) O Hadoop MapReduce grava dados intermediários em disco entre as fases de Map e Reduce, enquanto o Spark processa e retém dados preferencialmente na memória RAM.
( ) No Apache Spark, as transformações disparam imediatamente a computação física no cluster, enquanto as ações apenas registram as etapas no Grafo Acíclico Dirigido (DAG).
( ) A tolerância a falhas no HDFS ocorre pela replicação de blocos em múltiplos nós, enquanto no Spark ela se baseia no histórico de linhagem (lineage) para reconstituir partições perdidas.
As afirmativas são, respectivamente,

 Conheça nossos planos