Questões de Concurso Sobre banco de dados
Foram encontradas 19.112 questões


O mecanismo usualmente utilizado nos gerenciadores de bancos de dados para evitar o dirty read, enquanto a transação não for encerrada, é conhecido como:
No contexto do PostgreSQL, analise o comando SQL a seguir.
CREATE TABLE TESTE_X PARTITION OF TESTE
FOR VALUES IN ('SP', 'RJ');
Esse comando tem por finalidade:
O índice mais utilizado, e usualmente adotado por default em gerenciadores de bancos de dados relacionais, é conhecido genericamente como:
I. No modelo Simple Recovery, o banco de dados pode ser recuperado até o ponto de último backup, full ou differential.
II. No modelo Full Recovery, o banco de dados pode ser recuperado até o ponto da falha, ou certo ponto no tempo.
III. O modelo bulk model não requer backup dos logs na recuperação.
Está correto somente o que se afirma em:
R (A, B, C, D, E)
Sobre essas colunas (ou atributos), João levantou as dependências funcionais seguintes.
A -> B B -> C C -> D D -> E D -> A
Dentre os esquemas SQL esboçados por João, o que melhor representa a tabela R, com suas restrições, é:
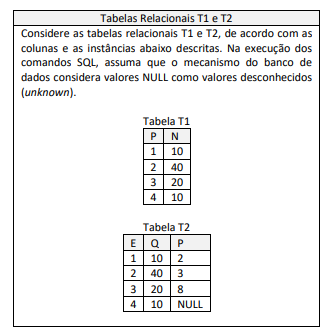
(1) P -> N (2) N -> P (3) E -> Q (4) E -> P (5) Q -> P (6) Q -> E (7) P -> E (8) P -> Q
Dessa lista enumerada, o conjunto completo das únicas dependências funcionais que poderiam ser corretamente depreendidas é:
select * from T1 full outer join T2 on T1.P=T2.P
Além da linha de títulos, a execução desse comando produz um resultado com:
delete from T2 where P not in (select P from T2)
O número de linhas deletadas da tabela T2 pela execução desse comando é:
select case when exists (select * from T2 where T2.E = 2 and T2.P = 3 and exists (select * from T1 where T1.P in (2,3,4) and T2.E in (2,3))) then 1 else 0 end flag
Sobre uma eventual execução desse script, é correto afirmar que:
Maria está implementando o Audit-DataMart para apoiar análises sobre a quantidade de auditorias realizadas por cidade e por período. Para isso, Maria elaborou o modelo multidimensional de dados no qual a dimensão tempo se relaciona com a tabela fato duas vezes, uma representando a data de início da auditoria e a outra representando a data do fim da auditoria, conforme ilustrado a seguir.
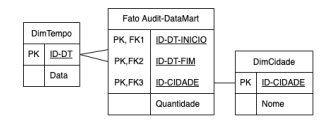
A técnica de modelagem multidimensional de dados utilizada por
Maria para referenciar múltiplas vezes uma única dimensão física
na tabela fato é:
• Produto A (Preço: R$ 50 e Peso: 300g) • Produto B (Preço: R$ 500 e Peso: 1000g)
Além disso, ele observa a presença de outliers nos dados. Nesse sentido, João deverá tratar os dados para garantir que as variáveis tenham uma distribuição normal, isto é, com média igual a zero e desvio padrão igual a um.
Para isso, a técnica de tratamento de dados que João deverá utilizar, levando em consideração a presença de outliers, é:
• 30% das entradas de dados na coluna CD_FUNCIONARIO estão marcadas com o caractere “espaço”
• existem 200 linhas na tabela TBL_PROCESSO contendo dados sobre processos sem nenhuma linha contendo os seus detalhes
Para isso, a técnica de diagnóstico sobre a qualidade de dados que João deverá utilizar é:
TipoDeUsuario(CodigoTipoUsu,DescricaoTipoUsu) Usuario(CodigoUsu,LoginUsu,CodigoTipoUsu) CodigoTipoUsu referencia TipoDeUsuario
Sobre o modelo lógico acima, é correto afirmar que:
No que se refere a modelagem dimensional, mineração de dados e big data, julgue o item subsequente.
No modelo CRISP-DM, a fase de preparação dos dados é caracterizada por atividades como análise da qualidade dos dados,
exploração dos dados, geração dos primeiros insights e formulação de hipóteses.
No que se refere a modelagem dimensional, mineração de dados e big data, julgue o item subsequente.
Na mineração de dados, a tarefa de classificação consiste em descobrir uma função que mapeie um conjunto de registros de dados
em um conjunto de variáveis predefinidas, e as redes neurais e back-propagation são tipos de algoritmos que se aplicam a essa
tarefa.
No que se refere a modelagem dimensional, mineração de dados e big data, julgue o item subsequente.
Na modelagem dimensional, a chave da tabela de fatos corresponde à associação das chaves primárias das tabelas de dimensões.
No que se refere a modelagem dimensional, mineração de dados e big data, julgue o item subsequente.
Em big data, a premissa variedade refere-se ao acréscimo dos volumosos tipos de dados semiestruturados e não estruturados aos
tradicionais conjuntos de dados estruturados das organizações, responsável por impor desafios contextuais adicionais para o
armazenamento, o tratamento e a análise dos dados dessas organizações.

 Conheça nossos planos