Questões de Concurso Sobre índices em banco de dados

Foram encontradas 208 questões

Q3781117 Banco de Dados
Um DBA está avaliando o desempenho de uma consulta que frequentemente busca dados na tabela Auditoria (com 500 milhões de registros) usando a coluna DataHora_Acesso na cláusula WHERE. O DBA decide criar um índice clusterizado nessa coluna (após remover o índice existente na chave primária autoincremento, se necessário).
Assinale a opção que apresenta a principal implicação técnica de criar um índice clusterizado na coluna DataHora_Acesso de uma tabela tão grande no MS SQL Server, e a consequência direta para a ordenação física dos dados. 
Alternativas
Q3781111 Banco de Dados
Uma consulta SQL que realiza múltiplos JOINs e filtros sobre tabelas grandes está apresentando lentidão.
As opções a seguir apresentam estratégias recomendadas para otimização, à exceção de uma. Assinale-a.
Alternativas
Q3781109 Banco de Dados
No SQL Server, uma das práticas recomendadas para otimizar o desempenho de consultas complexas, é o uso de índices compostos. Considere a seguinte situação:
Uma tabela de vendas (Vendas) contém as colunas data_venda, id_cliente, valor_total. Deseja-se otimizar a consulta que filtra registros por id_cliente e ordena por data_venda.
Assinale a opção que indica a configuração de índice mais adequada.
Alternativas
Q3765801 Banco de Dados
Em bancos relacionais, o otimizador escolhe planos a partir de estimativas e estruturas de acesso. Assinale a alternativa que representa estratégia consistente para consulta com predicado por intervalo e ordenação por duas colunas. 
Alternativas
Ano: 2025 Banca: IF-MT Órgão: IF-MT Prova: IF-MT - 2025 - IF-MT - Analista de TI |
Q3755891 Banco de Dados
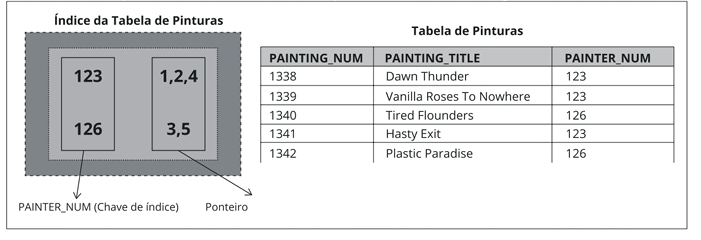
Considerando a figura a seguir, que apresenta como exemplo um índice para uma tabela de pinturas em um banco de dados, o ponteiro de número 4 se refere a qual item da coluna “Painting_Title"? 

Imagem associada para resolução da questão

Fonte: adaptado de Rob e Coronel (2011). Disponivel em: https://www.univates.br/revistas/index.php/destaques/article/view/498/490. 
Alternativas
Q3755428 Banco de Dados
No contexto de tuning de consultas em bancos de dados relacionais, certas práticas podem introduzir sobrecarga desnecessária ou impedir o uso eficiente de índices.
Assinale a opção que corresponde a uma prática que deve ser evitada por resultar, em geral, em pior desempenho.
Alternativas
Q3753096 Banco de Dados
Considere a seguinte situação hipotética:
Um sistema acadêmico armazena milhões de registros na tabela usuario, e as consultas que filtram pela coluna email estão apresentando lentidão significativa. Para otimizar o desempenho dessas consultas, o desenvolvedor decide criar um índice específico para essa coluna.

Considerando o SGBD PostgreSQL 15, assinale a alternativa que o desenvolvedor deve utilizar para criar CORRETAMENTE o índice:
Alternativas
Q3696963 Banco de Dados
Uma query que junta as tabelas Vendas (10.000 linhas) e Clientes (1.000 linhas) está performando mal. Ambas as tabelas têm índices nas colunas de junção (cliente_id). Analisando o plano de execução, o DBA verifica que o otimizador escolheu um Nested Loops Join. Em qual cenário essa escolha é a mais adequada? 
Alternativas
Q3696960 Banco de Dados
Ao analisar um plano de execução no PostgreSQL usando EXPLAIN ANALYZE, um DBA observa uma operação Sequential Scan em uma tabela grande para uma query que deveria usar um índice. Qual é a causa mais provável para o otimizador ter escolhido o acesso sequencial completo em vez do índice? 
Alternativas
Q3696956 Banco de Dados
Ao analisar o plano de execução de uma query lenta, um DBA observa a operação TABLE ACCESS FULL sobre uma tabela grande. A query frequentemente filtra resultados usando uma cláusula WHERE em uma coluna data_cadastro. Não existem índices nesta coluna. Qual seria a ação mais direta e efetiva para melhorar o desempenho desta query?
Alternativas
Q3696955 Banco de Dados
Um DBA é chamado para analisar uma query de relatório que está executando lentamente. A query filtra registros usando a cláusula WHERE em uma coluna status que possui apenas 5 valores distintos ('A', 'I', 'P', 'C', 'X') em uma tabela com 10 milhões de linhas. A distribuição dos valores é muito desigual: 9.9 milhões têm status 'A' e os outros 100 mil estão distribuídos entre os demais status. Qual tipo de índice seria mais eficiente para acelerar consultas que buscam por um dos valores menos frequentes, como WHERE status = 'P'?
Alternativas
Q3684262 Banco de Dados

Em relação a ferramentas de busca, indexação e análise de dados, julgue o item subsecutivo. 


O Elasticsearch permite a divisão de um índice em subpartes denominadas shards, as quais devem ser remontadas para se tornarem funcionais, uma vez que não podem ser utilizadas isoladamente.  

Alternativas
Q3684255 Banco de Dados

Acerca de otimização de desempenho de sistemas gerenciadores de banco de dados (SGBD) e de consultas SQL, julgue o item subsequente.


Em um SGBD, o índice de seletividade representa a eficiência de acesso aos dados, sendo a alta seletividade mais eficaz que a baixa seletividade para localizar os dados. 

Alternativas
Q3641012 Banco de Dados
Com base nos conceitos relacionados aos índices em bancos de dados relacionais, assinale a opção correta.  
Alternativas
Q3636610 Banco de Dados
Um módulo de protocolo eletrônico em um órgão federal mantém a tabela Processo com aproximadamente 30 milhões de linhas e chave primária na coluna Id. A equipe estuda criar índices adicionais em CpfInteressado, Situacao, DataCriacao e no par (Unidade, DataDistribuicao) para acelerar consultas e ordenações. A carga de trabalho é mista: cerca de 60% de operações de leitura e 40% de escrita (inserções, atualizações e exclusões), com picos ao longo do expediente. Considerando o efeito geral dos índices nesse contexto, assinale a alternativa correta. 
Alternativas
Q3535940 Banco de Dados
        Em um sistema de gerenciamento de banco de dados relacional (SGBDR), uma aplicação começou a apresentar lentidão crescente nas consultas SQL. Após análise, observou‑se que a tabela envolvida apresentava milhões de registros e consultas frequentes por colunas específicas.
Com base nessa situação hipotética, assinale a opção que apresenta a ação adequada para otimizar o desempenho das consultas nesse cenário.
Alternativas
Q3508336 Banco de Dados

Em um sistema de e-commerce, foi criado um índice do tipo hash sobre a coluna preço da tabela produtos. Esse índice está sendo utilizado em consultas com filtros como:


SELECT * FROM produtos WHERE preco BETWEEN 100 AND 300;


I. Índices hash são ineficientes para consultas com operadores de intervalo, como BETWEEN, porque sua estrutura não mantém ordenação dos valores indexados.


II. A atualização de índices hash ocorre na reconstrução completa do índice sempre que um novo registro é inserido na tabela produtos em sistemas de banco de dados como PostgreSQL e MySQL.


III. A limitação dos índices hash em consultas de intervalo reside em sua restrição a campos numéricos, o que os tornam inutilizáveis para campos textuais ou data. 


É correto o que se afirma em:

Alternativas
Q3508311 Banco de Dados
Em um sistema de banco de dados relacional, que gerencia uma tabela com milhões de registros, é necessário otimizar consultas em uma coluna textual (VARCHAR(100)) que armazena nomes de produtos. A consulta mais comum utiliza o padrão LIKE 'prefixo%' para buscar produtos que começam com um prefixo específico, como SELECT * FROM produtos WHERE nome_produto LIKE 'eletr%';. Além disso, a tabela possui alta cardinalidade (muitos valores distintos) e é frequentemente atualizada com inserções e alterações. Considerando os diferentes tipos de índices disponíveis e suas características, assinale a alternativa que apresenta o tipo de índice mais eficiente para otimizar essas consultas, levando em conta tanto a performance de leitura quanto o impacto em operações de escrita: 
Alternativas
Q3506013 Banco de Dados

Considere as seguintes assertivas sobre técnicas de otimização e projeto de bancos de dados e marque V, para as verdadeiras, e F, para as falsas:


(__) A desnormalização do esquema de banco de dados é uma técnica que busca eliminar toda e qualquer redundância, garantindo a maior consistência possível dos dados.


(__) A operação de junção (JOIN) é reconhecida como uma das operações que potencialmente mais consomem tempo no processamento de consultas.


(__) Em um otimizador de consulta baseado em custo, o sistema estima e compara os custos de diferentes estratégias de execução para escolher a mais eficiente.


(__) A criação de índices em atributos que não são usados em cláusulas de junção ou seleção melhora o desempenho das consultas, pois permite que todos os caminhos de acesso à tabela sejam otimizados igualmente.


A alternativa que apresenta a sequência correta é:

Alternativas
Q3506012 Banco de Dados

Sobre a otimização (tuning) de consultas em bancos de dados relacionais, avalie as afirmações apresentadas a seguir:


I. Consultas com múltiplas condições de seleção conectadas pelo operador lógico OR podem não utilizar índices eficientemente e podem ser otimizadas dividindo-as em uma união (UNION) de consultas separadas.


II. O uso desnecessário da cláusula DISTINCT pode ser evitado sem alterar o resultado em alguns casos, o que é benéfico, pois DISTINCT frequentemente causa uma operação de ordenação onerosa.


III. Consultas aninhadas correlacionadas são sempre mais eficientes do que suas versões não aninhadas ou reescritas como JOINs, pois o SGBD otimiza sua execução avaliando a subconsulta apenas uma vez.


IV. Expressões aritméticas ou comparações envolvendo valores NULL ou substrings em cláusulas WHERE podem, em alguns casos, impedir que o otimizador de consulta utilize índices relevantes.


É correto o que se afirma em:

Alternativas
Respostas
41: E
42: A
43: D
44: A
45: D
46: A
47: A
48: C
49: D
50: C
51: B
52: E
53: C
54: B
55: C
56: C
57: A
58: A
59: D
60: B