Questões de Concurso
Sobre definição do modelo em estatística
Foram encontradas 19 questões


A respeito das propriedades e características dos métodos de agrupamento, analise as afirmativas de I a VI abaixo:
I. O método K-means é classificado como um método de agrupamento hierárquico e tem como principal vantagem a dispensa da definição prévia do número de grupos (clusters) pelo pesquisador.
II. O método do vizinho mais próximo (ou ligação simples) define a distância entre dois agrupamentos como a distância mínima entre qualquer par de observações, um de cada agrupamento, sendo altamente suscetível ao efeito de encadeamento (chaining).
III. O método do vizinho mais distante (ou ligação completa) calcula a distância entre os grupos considerando a distância máxima entre os seus pontos, o que tende a produzir agrupamentos mais compactos e de tamanhos similares.
IV. No método do centroide, a distância entre dois clusters é a distância entre as médias das observações de cada grupo. Uma de suas vantagens é a garantia matemática de que o dendrograma nunca apresentará inversões (reversões).
V. O algoritmo K-means funciona iterativamente para minimizar a variância intragrupo, contudo é bastante sensível à presença de outliers (valores atípicos), que podem deslocar drasticamente a posição dos centroides.
VI. Os métodos do vizinho mais próximo, vizinho mais distante e centroide são algoritmos hierárquicos aglomerativos, enquanto o K-means é essencialmente um método de partição nãohierárquico.
Assinale a ÚNICA alternativa que apresenta todos os itens CORRETOS.
Acerca das características e do funcionamento dessa técnica, analise os itens a seguir. I. De acordo com a técnica, cada gaussiana no modelo de mistura possui três parâmetros principais: média, peso e matriz de covariância. II. O modelo calcula para cada instância a probabilidade de ela ter sido gerada por cada um dos componentes da mistura. III. Os agrupamentos gerados por essa técnica são matematicamente limitados a formatos esféricos, impossibilitando a modelagem de distribuições elípticas ou com volumes distintos no espaço de dados. Está correto o que se afirma em
Uma universidade pública deseja criar um modelo para classificar candidatos ao curso de Estatística em três categorias: "baixo risco de evasão", "médio risco" e "alto risco", com base em variáveis preditoras contínuas (nota no ENEM, coeficiente de rendimento no ensino médio, horas de estudo semanais, renda familiar per capita). O estatístico da instituição opta pela Análise Discriminante Linear (ADL) como técnica de classificação supervisionada.
Assinale a alternativa que apresenta corretamente uma premissa fundamental da ADL e um procedimento de validação apropriado.
Com base nessa situação e nos princípios dos métodos de multicritério, é CORRETO afirmar que:
O professor instruiu o aluno de iniciação científica em
química a apresentar, em seu relatório semestral, a média
dos valores obtidos de densidade do ferro, seguido de
um indicador que representasse a exatidão da medida.
No campo da estatística, a exatidão pode ser expressa
pelo seguinte cálculo:
Acerca de planejamento de pesquisa estatística, julgue o item que se segue.
Em um modelo estatístico, o erro total corresponde à soma
dos desvios das observações em relação ao modelo.
No estudo da análise multivariada, existe uma técnica para análise de dados que tem como objetivo dividir os elementos da amostra, ou população, em grupos de forma que os elementos pertencentes a um mesmo grupo sejam similares entre si com respeito às variáveis que neles foram medidas, e os elementos em grupos diferentes sejam heterogêneos com relação a essas mesmas características.
Essa técnica denomina-se análise
Selecionou-se uma amostra aleatória simples, de tamanho 16, Y1 , Y2 , ..., Y16 , para se estudar uma característica tal que:
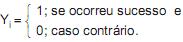
Sabe-se que ocorreram 10 sucessos.
A variância dessa amostra é
I. Seja X uma variável aleatória normal univariada com média µ1 e variância σ21 e Y uma variável aleatória normal univariada com média µ2 e variância σ22 . Nessas condições, o vetor
 tem distribuição normal bivariada.
II. Se Σ é a matriz de covariâncias de um determinado vetor aleatório, então Σ é uma matriz positiva definida.
III. A variância total de um vetor aleatório é dada pelo traço de sua matriz de covariâncias.
IV. Se
 é a matriz de covariâncias do vetor aleatório X de dimensão (2X1), então a matriz de correlações de X é
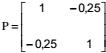
Está correto o que consta APENAS em
No agrupamento hierárquico, o critério denominado complete-linkage consiste em atualizar as distâncias entre dois grupos recém-agrupados como sendo o valor mínimo entre eles.
I. Na análise de correlação canônica, a ideia básica é resumir a informação de cada conjunto de variáveis resposta em combinações lineares, sendo que a escolha dos coeficientes dessas combinações deve ter como critério a minimização da correlação entre os conjuntos de variáveis resposta.
II. A análise de correspondência é adequada quando se quer examinar a relação entre variáveis categóricas nominais ou entre categorias dessas variáveis.
III. A análise de regressão múltipla é exemplo de uma técnica de interdependência.
É correto o que consta APENAS em
 ,
e de Czekanowski,
 , podem ser
aplicadas nas situações em que – ∞ < xi, yi
< + ∞.
I. A análise fatorial é um exemplo de técnica de interdependência, o que significa que nenhuma variável ou grupo de variáveis é definida como sendo dependente ou independente.
II. A análise de correlação canônica não é adequada se as variáveis independentes são quantitativas.
III. A análise discriminante múltipla é adequada se a única variável dependente for categórica.
IV. A análise de correspondência não é adequada para teste de hipóteses.
Está correto o que se afirma APENAS em
Os modelos de redução da incerteza são classificados em forecasting (destinados a simular processos ou fenômenos que já ocorreram) e backcasting (modelos de previsão de cenários).

 Conheça nossos planos