Foram encontradas 911 questões

Resolva questões gratuitamente!

Junte-se a mais de 4 milhões de concurseiros!

Q1892816 Engenharia de Software
Uma organização está implementando um sistema de busca de informações interno, e a equipe de desenvolvimento resolveu avaliar diferentes modelos de linguagem vetoriais que ajudariam a conectar melhor documentos e consultas em departamentos que usam terminologias distintas em áreas de negócio que se sobrepõem. Um dos analistas ressaltou que seria interessante guardar os vetores de todo o vocabulário do modelo em um cache, de forma a aumentar a eficiência de acesso e reduzir certos custos de implantação.
Das alternativas abaixo, aquela que lista apenas os modelos compatíveis com essa estratégia de caching é:
Alternativas
Q1892815 Direito Digital
Conjuntos de dados identificados de pessoas são úteis em pesquisas, ao mesmo tempo que são motivo de preocupação em relação à privacidade das pessoas naturais envolvidas. A classificação de atributos identificadores ajuda a priorizar atividades de desidentificação para alavancar a pesquisa sob a observância da LGPD.
São exemplos: a) de identificadores explícitos, b) de identificadores sensíveis e c) de quasi identificadores:
Alternativas
Q1892814 Governança de TI
A universidade YEDU implantou um sistema ERP (Enterprise Resource Planning) no final da década de 1990. Ao longo dos anos, foram feitas diversas customizações para atender novas demandas de negócio. Após um tempo, tornou-se evidente uma disparidade de dados na YEDU. Um mesmo aluno era visto em até seis sistemas. Para agravar ainda mais essa disparidade, os nomes e os atributos dos alunos foram preenchidos com diversos erros de digitação em cada sistema. Os sistemas de BI não possuíam recursos para mostrar uma visão única de cada aluno.
A alta administração da YEDU decidiu então implementar um programa de Gestão e Governança de Dados. Para resolver o problema de repetições de dados de alunos na YEDU, o CDO (Chief Data Officer) definiu corretamente a seguinte abordagem:
Alternativas
Q1892813 Algoritmos e Estrutura de Dados
Considere os documentos A e B a seguir.
A = “Há pessoas que choram por saber que as rosas têm espinho” B = “Há outras que sorriem por saber que os espinhos têm rosas”
A submatriz da matriz de TF-IDF desses dois documentos correspondente aos termos “Rosas”, “Choram” e “Sorriem”, nessa ordem, é:
Alternativas
Q1892812 Programação
A tabela presente no código em R abaixo apresenta a quantidade de processos analisados por três analistas (denotados por A1, A2 e A3) em diferentes anos.
dados = tibble::tibble(Analista=c(“A1”, “A1”, “A1”, “A2”, “A2”, “A3”, “A3”, “A3”),
Ano=c(2018,2019,2020,2019,2020,2018,2019,2020), Processos=c(10,15,20,25,20,8,7,12))
Um programador roda o código abaixo em R.
tidyr::pivot_wider(data=dados, names_from=”Analista”, values_from=”Processos”)

Os valores esperados na primeira linha do objeto resultante do comando acima são: 
Alternativas
Q1892811 Banco de Dados
Um analista do TCU gostaria de aplicar um modelo de Latent Dirichlet Allocation (LDA) em um conjunto de textos. A alternativa que melhor descreve o resultado do modelo é:
Alternativas
Q1892810 Banco de Dados
Um analista de dados deseja criar um modelo para classificação de documentos em duas categorias: sigilosos e públicos. À sua disposição, existe um conjunto de dados com N documentos, dos quais uma fração α deles é sigilosa. O analista quer escolher uma fração β dos N documentos para pertencer ao conjunto de teste. O objetivo é garantir que cada uma das classes (documentos sigilosos e públicos) seja responsável, em média, por ao menos 10% do total de documentos. Essa restrição precisa ser válida tanto no conjunto de treino quanto no conjunto de teste. Um par (α,β) que satisfaz as restrições do analista é:
Alternativas
Q1892809 Engenharia de Software
Seja uma rede neural com camada de entrada com dimensão dois que recebe dados (x1 , x2 ). Essa rede aplica pesos w1 em x1 , w2 em x2 e adiciona um viés w0 . A função de ativação é dada pela função sinal s(z) = +1, se z ≥ 0, e s(z) = -1, se z < 0. Essa rede não tem nenhuma camada oculta e será utilizada para classificar observações em y=+1 ou y=-1.
Para pesos w1 = 2, w2 = 3 e viés w0 = 1, a região de classificação é uma reta que passa nos pontos:
Alternativas
Q1892808 Banco de Dados
Em um problema de classificação é entregue ao cientista de dados um par de covariáveis, (x1 , x2 ), para cada uma das quatro observações a seguir: (6,4), (2,8), (10,6) e (5,2). A variável resposta observada nessa amostra foi “Sim”, “Não”, “Sim”, “Não”, respectivamente.
A partição que apresenta o menor erro de classificação quando feita na raiz (primeiro nível) de uma árvore de decisão é: 
Alternativas
Q1892807 Banco de Dados
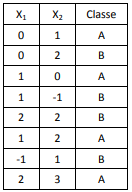
Um analista do TCU recebe o conjunto de dados com covariáveis e a classe a que cada amostra pertence na tabela a seguir.
Imagem associada para resolução da questão

Esse analista gostaria de prever a classe dos pontos (1,1), (0,0) e (-1,2) usando o algoritmo de k-vizinhos mais próximos com k=3 e usando a distância euclidiana usual.
Suas classes previstas são, respectivamente:
Alternativas
Q1892806 Banco de Dados

ATENÇÃO!

Para a questão a seguir, considere uma tabela relacional R, com atributos W, X, Y, Z, e o conjunto de dependências funcionais identificadas para esses atributos.


 Y

 Z

 X

 W

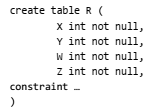
Com referência à tabela R, definida anteriormente, considere o esboço de um comando SQL para a criação da tabela.
Imagem associada para resolução da questão

De acordo com as dependências funcionais de R, e com a Forma Normal de Boyce-Codd, a definição correta das chaves (por meio de constraints) aplicáveis e necessárias para essa tabela deveria ser: 
Alternativas
Q1892805 Banco de Dados

ATENÇÃO!

Para a questão a seguir, considere uma tabela relacional R, com atributos W, X, Y, Z, e o conjunto de dependências funcionais identificadas para esses atributos.


 Y

 Z

 X

 W

Analise o conjunto de dependências funcionais inferidas abaixo a partir do conjunto de atributos e dependências funcionais presentes na tabela R, como descrita anteriormente.
(1)    X  Y Z W (2)    X  W (3)    X W  Y W (4)    X Y Z W  X Y (5)    Y  Z
À luz dos axiomas da teoria de projeto de bancos de dados aplicáveis nesse caso, é correto concluir que, dentre essas dependências inferidas:
Alternativas
Q1892804 Programação
Natasha, uma cientista de dados, está trabalhando com um conjunto de dados sobre carros para fazer um modelo preditivo para uma companhia de seguros. A primeira versão do modelo utiliza apenas informações básicas sobre os carros: a marca e a cor.
Como esses dados são categóricos, Natasha faz um pré-processamento usando a biblioteca scikit-learn. Em um ambiente interativo, ela executa os comandos a seguir. 
>>> from sklearn.preprocessing import OneHotEncoder >>> enc = OneHotEncoder() >>> X = [['Toyota', 'vermelho'], ['Toyota', 'verde'], ['BMW', 'vermelho']]
>>> enc.fit(X) >>> enc.get_feature_names() array(['x0_BMW', 'x0_Toyota', 'x1_verde', 'x1_vermelho'], dtype=object)
>>> X_prime = enc.transform(X).toarray() >>> X_prime array([[0., 1., 0., 1.], [0., 1., 1., 0.], [1., 0., 0., 1.]]) 

Para contar o número de carros da marca Toyota no conjunto de dados, obtendo corretamente o resultado 2, Natasha pode usar a seguinte linha de código:
Alternativas
Q1892803 Programação
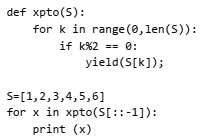
Considere o código Python a seguir.
Imagem associada para resolução da questão

A execução desse código na IDLE Shell produz, na ordem e exclusivamente, os números: 
Alternativas
Q1892802 Banco de Dados

ATENÇÃO!

Na próxima questão, considere as tabelas de banco de dados T, TX e DUAL, exibidas com suas respectivas instâncias a seguir.


TX 


DUAL


Nas colunas das três tabelas, o tipo é o de número inteiro. Em todos os comandos SQL, considera-se o NULL como um valor desconhecido (unknown).


Analise os cinco comandos SQL exibidos abaixo, utilizando a tabela DUAL apresentada anteriormente.
(1) select * from dual where x = null (2) select * from dual where x <> null (3) select * from dual where x > 10 (4) select * from dual where not x > 10 (5) select * from dual where x > 10 union select * from dual where x <= 10
Se os resultados desses comandos fossem separados em grupos homogêneos, de modo que em cada grupo todos sejam idênticos e distintos dos elementos dos demais grupos, haveria:
Alternativas
Q1892801 Banco de Dados

ATENÇÃO!

Na próxima questão, considere as tabelas de banco de dados T, TX e DUAL, exibidas com suas respectivas instâncias a seguir.


TX 


DUAL


Nas colunas das três tabelas, o tipo é o de número inteiro. Em todos os comandos SQL, considera-se o NULL como um valor desconhecido (unknown).


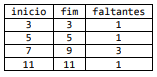
Supondo que a coluna sequencia da tabela T, anteriormente definida, deveria conter números inteiros em sequência contínua, seria preciso descobrir os intervalos de valores faltantes. Um valor é considerado faltante quando a) é um número inteiro n entre o menor e o maior valor da tabela, tal que n não esteja presente na tabela, ou b) é um número presente na tabela T, com valor nulo na coluna caracteristica.

Imagem associada para resolução da questão

O comando SQL que produz o resultado acima, a partir da instância inicialmente definida para a tabela T, é:
Alternativas
Q1892800 Banco de Dados

ATENÇÃO!

Na próxima questão, considere as tabelas de banco de dados T, TX e DUAL, exibidas com suas respectivas instâncias a seguir.


TX 


DUAL


Nas colunas das três tabelas, o tipo é o de número inteiro. Em todos os comandos SQL, considera-se o NULL como um valor desconhecido (unknown).


Considere que é preciso atualizar os dados da tabela T a partir dos dados da tabela TX, ambas definidas anteriormente. A consolidação é feita por meio da alteração na tabela T a partir de registros de TX.
O comando SQL utilizado nessa atualização é exibido a seguir.
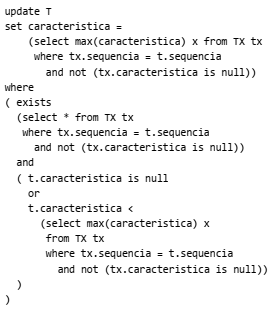
Imagem associada para resolução da questão

O número de registros da tabela T afetados pela execução do comando SQL acima é: 

Alternativas
Q1892799 Estatística
A demanda de um certo serviço público no mês t é modeladapela equação 20 + 3t + 2D(t) + εt, onde D(t) = 1, se t = 6, e 0, casocontrário, e ε é um ruído com média zero e variância 4.
As previsões de demanda nos meses 6 e 12 são, respectivamente:
Alternativas
Q1892798 Estatística
Numa empresa com 100 funcionários, todos foram perguntados a respeito de suas preferências sobre trabalho remoto ou presencial. Dos funcionários de 18 a 39 anos, 40% preferem trabalho presencial. Dos funcionários acima de 40 anos, 40% mostraram preferência pelo remoto. Dos 100 funcionários, 50 têm mais de 40 anos. O presidente da empresa está interessado em saber se a preferência por trabalho remoto é independente da categoria de idade (18 a 39 e acima de 40 anos).
O teste a ser usado pelo presidente e o valor da estatística de teste são, respectivamente:

Alternativas
Q1892797 Estatística
A média e a variância de uma distribuição binomial são, respectivamente, 20 e 4. O número de ensaios (n) dessa distribuição é:
Alternativas
Respostas
461: D
462: B
463: C
464: C
465: A
466: E
467: C
468: C
469: B
470: D
471: A
472: C
473: D
474: C
475: A
476: B
477: C
478: A
479: D
480: C