Questões de Concurso
Comentadas para analista de banco de dados
Foram encontradas 1.627 questões
Resolva questões gratuitamente!
Junte-se a mais de 4 milhões de concurseiros!


Q1933600
Banco de Dados
Num banco de dados relacional, considere as tabelas T1 e T2,
criadas como descrito a seguir.
• T1 tem duas colunas, intituladas A e B, do tipo inteiro; a coluna A é declarada como primary key, e não aceita valores nulos.
• T2 tem duas colunas, intituladas C e A, do tipo inteiro; a coluna C é declarada como primary key, e não aceita valores nulos; a coluna A foi declarada como UNIQUE, não aceita valores nulos e ainda foi declarada como uma foreign key que referencia a coluna A da tabela T1.
À luz dessa estrutura, é correto afirmar que o relacionamento entre T1 e T2:
Q1933599
Programação
Analise o código Python a seguir.
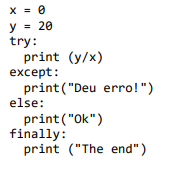
A saída produzida pela execução desse trecho é:
A saída produzida pela execução desse trecho é:
Q1933598
Programação
Analise o código Python a seguir.
s=0 for k in range(16,10, -2): s -= k print (s)
O valor exibido pela execução desse trecho é:
s=0 for k in range(16,10, -2): s -= k print (s)
O valor exibido pela execução desse trecho é:
Q1933597
Programação
Analise o código Python a seguir.
x1 = {"A", "B", "C"} x2 = ["AA", "BB", "CC"] x1.add("B") x2.append("BB") x2.append(x1) print (x2)
Dado que os elementos de x1 podem ser exibidos em ordem aleatória, a linha que possivelmente é produzida pelo comando print na execução do código acima é:
x1 = {"A", "B", "C"} x2 = ["AA", "BB", "CC"] x1.add("B") x2.append("BB") x2.append(x1) print (x2)
Dado que os elementos de x1 podem ser exibidos em ordem aleatória, a linha que possivelmente é produzida pelo comando print na execução do código acima é:
Q1933596
Estatística
No contexto da linguagem de programação R, analise as
afirmativas a seguir.
I. Vetores (vectors) são listas de itens que devem ter o mesmo tipo.
II. R trabalha com vários tipos de dados (data types), numéricos, lógicos e textuais, mas as variáveis podem mudar de tipo mesmo depois da instanciação.
III. Os itens de uma lista (list) não podem ser substituídos. São permitidas apenas a inserção e a remoção de itens.
Está correto somente o que se afirma em:
Q1933595
Programação
Analise o código da linguagem de programação R a seguir.
xpto <- array(c(1:24), dim = c(4, 3, 2)) print (xpto[3, 2, 1])
Na execução desse código, o print produz o valor:
xpto <- array(c(1:24), dim = c(4, 3, 2)) print (xpto[3, 2, 1])
Na execução desse código, o print produz o valor:
Q1933594
Estatística
No contexto da linguagem de programação R, analise o código a
seguir.
for (x in 1:10) { if (x >= 4) { print(x) next } if (x == 8) {break} }
O número de linhas exibidas pela execução desse código é:
for (x in 1:10) { if (x >= 4) { print(x) next } if (x == 8) {break} }
O número de linhas exibidas pela execução desse código é:
Q1933592
Estatística
O método Latent Dirichlet Allocation (LDA) é popularmente
utilizado para a construção de modelos de tópicos devido a sua
flexibilidade e robustez, particularmente em grandes quantidades
de texto. Ao mencionar a escolha do LDA em um projeto, um
analista foi questionado sobre que aspectos caracterizam a
flexibilidade do modelo, especialmente em comparação a um
modelo pLSA.
O analista respondeu corretamente:
O analista respondeu corretamente:
Q1933590
Estatística
A atividade de classificação de documentos envolve um grande
número de tarefas de processamento de linguagem natural, o
que pode levar a dúvidas quanto a sua aplicação.
A alternativa que contém apenas tarefas que sejam exemplos de classificação de documentos é:
A alternativa que contém apenas tarefas que sejam exemplos de classificação de documentos é:
Q1933587
Banco de Dados
O método random forests para classificação ou regressão
potencializa alguns benefícios das árvores de decisão e por isso é
preferido em certas situações.
O uso de random forests seria vantajoso em relação à árvore de decisão no seguinte caso:
O uso de random forests seria vantajoso em relação à árvore de decisão no seguinte caso:
Q1933585
Estatística
Em um trabalho de pesquisa, as idades das pessoas são: 23, 27,
32, 33, 34, 35, 36, 38, 42, 56 e 58. Deseja-se construir um boxplot
similar ao gráfico a seguir.
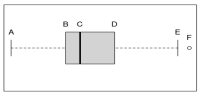
No boxplot acima, os valores das estatísticas nas posições indicadas pelas letras A, B, C, D, E e F são:
No boxplot acima, os valores das estatísticas nas posições indicadas pelas letras A, B, C, D, E e F são:
Q1933584
Estatística
Uma prefeitura recebeu uma denúncia de que o número de
autuações feitas pela equipe de fiscalização variava conforme o
dia da semana. Para verificar a procedência da denúncia, as
autuações foram agregadas por dia de semana, como mostra a
tabela a seguir.
Segundas 6 Terças 12 Quartas 9 Quintas 8 Sextas 15 Sábados 13 Domingos 7
Realizando um teste estatístico adequado para verificar se essas autuações ocorrem com a mesma frequência, teremos:
Segundas 6 Terças 12 Quartas 9 Quintas 8 Sextas 15 Sábados 13 Domingos 7
Realizando um teste estatístico adequado para verificar se essas autuações ocorrem com a mesma frequência, teremos:
Q1933583
Estatística
Uma empresa recebeu um lote muito grande, milhões de peças
de refugo, e deseja saber quantas peças deverá examinar para
estimar a proporção de itens defeituosos, de modo que o erro de
estimação seja no máximo 2%. Será empregada uma seleção
aleatória de itens onde cada um será classificado como
defeituoso ou não defeituoso. Deseja-se extrair uma amostra
aleatória de tamanho n.
Tendo como padrão um grau de confiança de 95%, o tamanho da amostra necessário para garantir o processo é:
Tendo como padrão um grau de confiança de 95%, o tamanho da amostra necessário para garantir o processo é:
Q1933579
Estatística
Na avaliação de um modelo para detecção de fraude, foi utilizado
um conjunto de dados conhecido que resultou na matriz de
confusão abaixo.
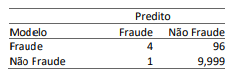
É correto afirmar que o modelo apresenta:
É correto afirmar que o modelo apresenta:
Q1933577
Estatística
Seja x uma amostra aleatória de tamanho 12. Foram então
geradas 10 amostras aleatórias com reposição de tamanho 12 de x e para cada uma delas foi calculada a mediana gerando os
seguintes valores: 3, 4, 4, 4 ,4, 5, 5 ,6 ,7 e 8.
A estimativa do erro padrão da mediana amostral é, aproximadamente:
A estimativa do erro padrão da mediana amostral é, aproximadamente:
Q1933575
Estatística
O tempo, em horas diárias, que homens com idades entre os 40 e
50 anos acessam redes sociais segue uma distribuição Normal
com média 2,5 e desvio padrão 1,5. Para o mesmo grupo etário
de mulheres, esse tempo segue também uma distribuição Normal
com média 3 e desvio padrão 1. Serão retiradas duas amostras
casuais e independentes, uma de homens e outra de mulheres.
O tamanho mínimo da amostra da população das mulheres que se pretende com probabilidade pelo menos 0,95 e cuja diferença em valor absoluto entre a média amostral e a média populacional não exceda 0,1 é, aproximadamente:
O tamanho mínimo da amostra da população das mulheres que se pretende com probabilidade pelo menos 0,95 e cuja diferença em valor absoluto entre a média amostral e a média populacional não exceda 0,1 é, aproximadamente:
Q1933574
Estatística
É possível que o comportamento das bolsas de valores em
determinado mês prediga o seu comportamento o ano inteiro.
Considere que a variável explicativa X seja a variação percentual
do índice da bolsa em janeiro e que a variável de resposta Y seja a
variação desse índice para o ano inteiro. O cálculo feito com
dados do período de 5 anos teve como resultados:
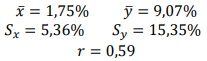
O percentual de variação observado nas alterações anuais do índice que é explicado pela relação linear com a alteração de janeiro é:
O percentual de variação observado nas alterações anuais do índice que é explicado pela relação linear com a alteração de janeiro é:
Q1933572
Estatística
As variáveis aleatórias X e Y são tais que Var(X) = 1, Var(Y) =
4 e Cor(X, Y) = −1.
O valor de Var(Y − 2X) é:
O valor de Var(Y − 2X) é:
Q1933570
Estatística
Um produtor de azeites comercializa seu produto em garrafas cujo
conteúdo, em litros, é uma variável aleatória com distribuição
normal com média μ = 1 litro e variância σ2 = 0,02 litro.
A percentagem de garrafas de azeite que contêm mais de 1 litro é:
A percentagem de garrafas de azeite que contêm mais de 1 litro é:
Q1933569
Estatística
A procura diária de conserto de celulares numa assistência
técnica é uma variável aleatória cuja função de probabilidade é
dada por  , para valores de x = 0, 1, 2, …
A probabilidade de, em determinado dia, a procura de conserto de celulares ser inferior à variância da distribuição é:
, para valores de x = 0, 1, 2, … A probabilidade de, em determinado dia, a procura de conserto de celulares ser inferior à variância da distribuição é:

 Conheça nossos planos