Questões de Concurso Sobre banco de dados
Foram encontradas 19.112 questões


Julgue o item seguinte, a respeito do desenvolvimento orientado ao comportamento (BDD).
A linguagem ubíqua Cucumber é utilizada para a definição
de cenários iniciais no BDD e permite que a equipe de
negócios faça levantamentos com as partes interessadas
(stakeholders) e os transforme em histórias do usuário
(user story).
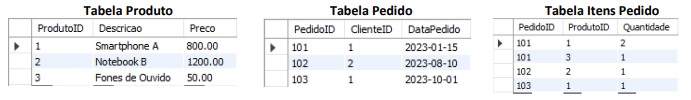
Determinado profissional deverá criar uma stored procedure chamada CalcularTotalPedido, que recebe um parâmetro PedidoID e calcula o valor total do pedido com base nos detalhes do pedido. Representa corretamente a implementação dessa stored procedure:
Livro (ISBN,Titulo, AnoPublicacao, IdAutor, NomeAutor, PaísOrigem, IdEditora, NomeEditora)
Em que forma normal se encontra esta tabela?
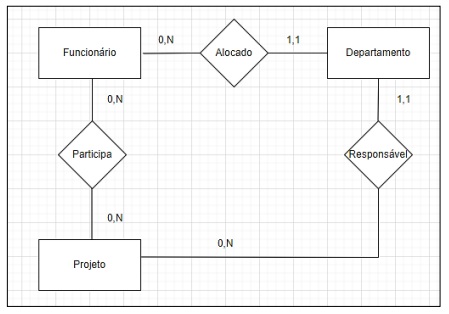
Analise as afirmativas a seguir.
I. A cardinalidade mínima 1 apresentada no diagrama recebe a denominação de “associação obrigatória”, já que ela indica que o relacionamento deve, obrigatoriamente, associar uma ocorrência de entidade a cada ocorrência da entidade em questão.
II. A cardinalidade máxima pode ser usada para classificar relacionamentos binários. É possível classificar os relacionamentos binários em n:n, 1:n e 1:1.
III. A cardinalidade 0 no diagrama indica que pode não haver associação (ninguém associado) a uma ocorrência da entidade a cada ocorrência da entidade em questão.
IV. A cardinalidade máxima indica o número máximo de ocorrências que cada associação deve ter; por exemplo, ao limitar um número máximo de 30 projetos por departamento, troca-se o 0 por 30 na relação projeto-departamento.
Está correto o que se afirma apenas em
( ) Existem diversas tecnologias para processamento e análise de Big Data, mas a maioria possui algumas características comuns. Ou seja, adotam técnicas de escalonamento e processamento paralelo; utilizam dados não relacionais, e aplicam análises avançadas e visualização de dados.
( ) Existem três tecnologias de Big Data que se destacam: MapReduce, Hadoop e NoSQL. O Hadoop é uma técnica popularizada pelo Google que distribui o processamento de dados em grandes arquivos de dados multiestruturados em um grande cluster que pode ser alcançado dividindo o processamento em pequenas unidades de trabalho que podem ser executadas em paralelo.
( ) O MapReduce é um modelo de programação e uma implementação associada para processar e gerar grandes conjuntos de dados. Os programas escritos neste estilo funcional são automaticamente paralelizados e executados em um grande cluster de máquinas de alto desempenho. O modelo que programadores sem qualquer experiência com sistemas paralelos e distribuídos utilizem facilmente os recursos.
As afirmativas são, respectivamente,
1. Orientados a Assunto.
2. Integração.
3. Não Volátil.
4. Variante no Tempo.
( ) O foco de um data warehouse na mudança ao longo do tempo é essencial para descobrir tendências e identificar padrões e relacionamentos ocultos nos negócios, para isso os analistas precisam de grandes quantidades de dados. Isso contrasta muito com o processamento de transações on-line onde os requisitos de desempenho exigem que os dados históricos sejam movidos para arquivos.
( ) Os data warehouses devem colocar dados de fontes diferentes em um formato consistente. Eles devem resolver problemas como nomear conflitos e inconsistências entre unidades de medida.
( ) Significa que, uma vez inseridos no data warehouse, os dados não devem mudar. Essa característica é lógica porque o propósito de um data warehouse é permitir que um analista analise o que ocorreu no passado.
( ) Os data warehousessão projetados para ajudar os profissionais a analisar grandes volumes de dados. Por exemplo, para saber mais sobre os dados de vendas de uma empresa, o analista pode construir um data warehouse que concentre a venda. Usando esse data warehouse, ele poderá responder perguntas como "Quem foi nosso melhor cliente para este item no ano passado?" ou "Quem provavelmente será nosso melhor cliente no próximo ano?"
A relação correta, na ordem dada, é:
( ) O operador LIKE é usado em uma cláusula WHERE para procurar um padrão especificado em uma coluna. Existem dois curingas frequentemente usados em conjunto com este operador; o sinal de % representa zero, um ou vários caracteres, já o sinal de - representa um único caractere.
( ) O operador IN permite especificar vários valores em uma cláusula WHERE. Ele é uma abreviação para múltiplas condições OR e AND sequenciais. Ao usar a palavra-chave NOT na frente do operador IN, haverá o retorno todos os registros que não são nenhum dos valores de uma lista.
( ) A palavra-chave RIGHT JOIN retorna todos os registros da tabela à direita em uma junção e os registros correspondentes da tabela à esquerda em uma junção. O resultado é zero registro do lado esquerdo, se não houver correspondência.
As afirmativas são, respectivamente,
O símbolo gráfico utilizado para representar uma entidade associativa no diagrama ER, considerando a notação Chen, é
I - Gestão da informação ou desempenho do negócio é um repositório de dados especiais preparado para dar suporte às aplicações de tomada de decisão.
II - Análise de negócio corresponde a uma série de ferramentas para manipular e analisar dados, incluindo processamento analítico, multidimensionalidade, mineração de dados e técnicas de análise avançada.
III - Data warehouse é um sistema para monitoria e comparação do desempenho da corporação às metas estabelecidas.
Quais estão corretas?
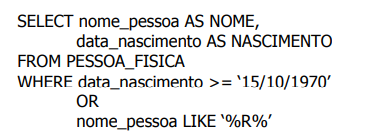
Considere as afirmações abaixo referentes à consulta SQL apresentada acima.
I - A condição para a recuperação das linhas contém duas expressões, porém, se qualquer uma delas for avaliada como verdadeira, a linha será apresentada no resultado.
II - A consulta lista nomes e datas de nascimento de todas as pessoas cujas datas de nascimento sejam maiores ou iguais a ‘15/10/1970’ e o nome da pessoa contenha a letra S.
III - O operador OR inverte o resultado da expressão avaliada, isto é, se a expressão for avaliada como verdadeira, com a utilização do operador, somente as linhas que não atendem à condição serão apresentadas.
Quais estão corretas?
Linha 1- Select E.nome + ‘fez a atividade’ + A.descricao
Linha 2- From Faz F join Encarregado E on (F.cpf = E.cpf) join Atividade A on (A.cod = F.cod)
Linha 3- Where E.nome like ‘$ANA$’ AND
Linha 4- E.salario != null AND
Linha 5- A.categoria between ‘C’ and ‘F’
O IBM Db2 é o banco de dados nativo em nuvem desenvolvido para impulsionar transações de baixa latência e análise de dados em tempo real em escala. Ele proporciona um mecanismo único para que DBAs, arquitetos corporativos e desenvolvedores mantenham as aplicações críticas funcionando, armazenem e consultem o que desejarem.
Disponível em:

 Conheça nossos planos