Questões de Concurso Sobre banco de dados
Foram encontradas 19.203 questões


A figura apresentada ilustra um modelo de dados implementado em MySQL 5.7, com a utilização de tabelas do tipo InnoDB. Considere que, trinta dias após a implementação dessas tabelas, os seguintes comportamentos foram observados:
 a tabela A apresentou 1 milhão de registros por dia;
 como critério de busca, em 20% das consultas realizadas na
tabela A, foram utilizados cinco caracteres ao final do campo
A2 e, no restante das consultas realizadas, utilizou-se um
número específico no campo B1 da tabela A;
 o campo B1 da tabela A continha uma chave estrangeira,
referenciada para o campo B1 da tabela B;
 a tabela B apresentava duzentos mil registros, a mesma
quantidade desde a data de sua implantação;
 todas as consultas realizadas na tabela B utilizaram, como
critério de busca, os cinco primeiros caracteres do campo B2;
 as tabelas A e B apresentaram quantidade fixa de consultas
diárias, igual a dez acessos e um milhão de acessos,
respectivamente.
Para criar um índice no campo A4, é obrigatória a determinação de um prefixo de caracteres.
Transação é uma coleção de operações de escrita e(ou) leitura, que representa uma única unidade de trabalho.
Os bloqueios no modo compartilhado são considerados compatíveis entre si, visto que bloqueios simultâneos, nesse modo, podem ser mantidos por diferentes transações sobre um mesmo item de dados.
Uma transação é considerada estagnada quando aguarda, por tempo indeterminado, a obtenção de um bloqueio no modo compartilhado, enquanto uma segunda transação está sendo realizada no modo de bloqueio exclusivo.
Caso uma transação obtenha um bloqueio no modo compartilhado sobre um item de dados, essa transação poderá ler o item de dados e, também, escrever nele.
O isolamento de uma transação, de responsabilidade do componente de gerenciamento de controle de concorrência, pode ter o seu comportamento personalizado em vários níveis.
0 Considerando-se o diagrama entidade-relacionamento ilustrado a seguir, bem como as informações apresentadas na sequência, é correto afirmar que o atributo codigo_superior deve ser NOT NULL para permitir a inserção de informações das unidades organizacionais e sua hierarquia.
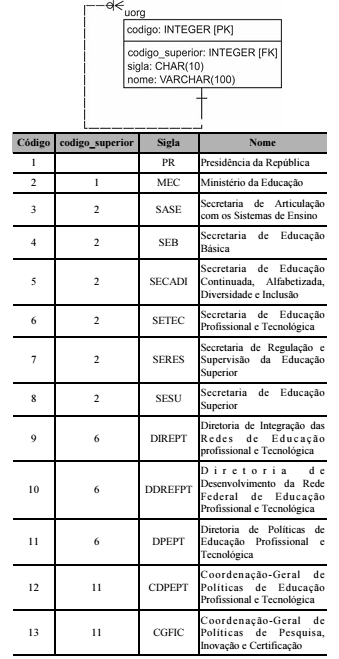
Em um processo de modelagem de dados, a cardinalidade define o número de ocorrências de uma entidade associadas às ocorrências de outra entidade por meio de um relacionamento específico.
No processo de modelagem do banco de dados, o modelo conceitual deve realizar uma descrição das estruturas onde serão armazenados os dados, uma vez que, nessa fase, é fundamental ter definida a estrutura do sistema gerenciador de banco de dados.
A replicação total implica cópia das tabelas em todos os servidores envolvidos no projeto, de modo a aumentar a disponibilidade dos dados para que o sistema continue a processar consultas que envolvam as tabelas independentemente da falha de algum servidor.
Em um sistema gerenciador de banco de dados distribuídos, o acesso transparente ocorre quando usuários interagem com o sistema como se este fosse um único sistema lógico.
Um sistema de bancos de dados distribuídos consiste em sítios fortemente acoplados, que compartilham tanto a memória primária quanto dispositivos de armazenamento secundário.
Um banco de dados distribuído é aquele cujos dados estão armazenados em diversos bancos de dados localizados em sítios distintos, o que gera como resultado a união lógica desses bancos de dados reais.
Em um ambiente distribuído de banco de dados, a confiabilidade consiste em uma coleção de sistemas de monitoramento da atividade de tráfego de informações sobre a rede de interconexão dos servidores de aplicação.
Uma tabela de fatos em um data warehouse armazena os valores detalhados de medidas, ou de valores observados, e as identifica com ligação para tabelas de dimensão.
Data warehouse é um banco de dados projetado para obter melhor desempenho na consulta e análise de dados, em vez de processamento de transações.
A operação roll-up aumenta o nível de agregação dos dados, agrupando-os em unidades maiores ao longo da dimensão, ao passo que a operação drill-down fornece uma visão mais detalhada dos dados.
O conhecimento obtido no processo de data mining pode ser classificado como uma regra de associação quando, em um conjunto de eventos, há uma hierarquia de tuplas sequenciais.
Algoritmo genético é uma das ferramentas do data mining que utiliza mecanismos de biologia evolutiva, como hereditariedade, recombinação, seleção natural e mutação, para solucionar e agrupar problemas.
A predição em algoritmos de data mining objetiva modelar funções sobre valores para apresentar o comportamento futuro de determinados atributos.

 Conheça nossos planos