Questões de Concurso Sobre banco de dados
Foram encontradas 19.183 questões


Considere um banco de dados de uma transportadora desenvolvido em MySQL. A tabela
da Frota é exibida na figura abaixo, na qual o sistema da empresa registra a atualização da
quilometragem no campo Km a cada retorno de uma atividade de transporte. A empresa deseja
implementar um controle de manutenção preventiva de acordo com a quilometragem
percorrida a partir da implantação do controle. Para isso, foram criadas duas tabelas adicionais
e um Trigger que também são exibidos abaixo. A tabela de Controle define o padrão de
manutenção preventiva por tipo de veículo, usando como base as quilometragens percorridas
por cada veículo para agendar as manutenções de forma automatizada para cada veículo. A tabela ManAgenda mantém os agendamentos de manutenção cadastrados. Assim, na
implementação do controle, a tabela ManAgenda está vazia. A análise do Trigger é condição
suficiente para verificar como os campos das tabelas são utilizados. As siglas PK (Primary Key)
e FK (Foreign Key) destacadas como legenda em cada tabela, referem-se às chaves primárias e
às chaves estrangeiras das tabelas.
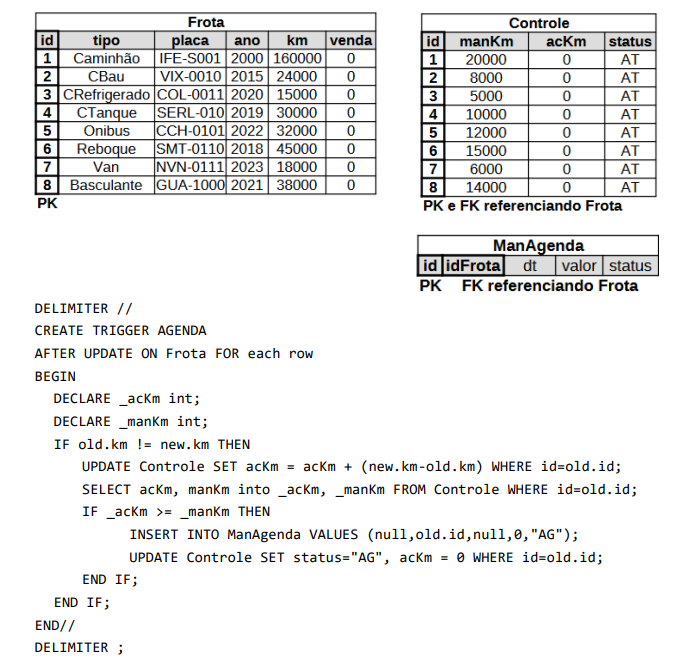
Suponha que após a implantação dos controles, cada veículo da Frota realizou 1 transporte de 3000km em agosto, 1 transporte de 4000km em setembro e 1 transporte de 2000km em outubro. Após essas 3 ações de transporte, qual alternativa corresponde ao que estará armazenado na tabela ManAgenda e na Tabela de Controle, com base no Trigger e nos dados iniciais apresentados das tabelas.
Obs: para evitar condição de corrida, admita que cada veículo teve sua quilometragem
atualizada após cada um dos transportes seguindo a mesma ordenação da tabela Frota.
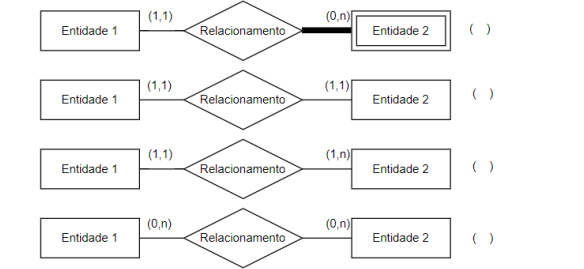
Na modelagem de banco de dados, os mapeamentos de um modelo conceitual de entidade e relacionamento para o modelo lógico seguem alguns princípios e técnicas para manter a integridade dos relacionamentos. Esses mapeamentos podem ser implementados por 3 regras numeradas abaixo:
1. Tabela Própria (Cria-se outra tabela que representará o relacionamento)
2. Adição de Coluna (Cria-se uma coluna adicional em uma das entidades como Chave Estrangeira)
3. Fusão de Tabelas (As duas entidades do relacionamento são fundidas em uma única tabela)
Considere os exemplos de possíveis relacionamentos conceituais, nas opções abaixo, e indique
o número da regra de implementação mais recomendada em cada um dos casos, assinalando
a alternativa que melhor corresponde às regras de implementação indicadas, na ordem de cima
para baixo.

1. Abstract Factory
2. Builder
3. Strategy
4. Facade
5. Observer
Analise as características dos padrões relacionadas abaixo, assinalando a alternativa que corresponde aos padrões associados de acordo com sua característica de cima para baixo:
( ) Este padrão fornece uma interface para criação de famílias de objetos relacionados ou dependentes sem especificar suas classes concretas.
( ) Este padrão separa a construção de um objeto complexo da sua representação, permitindo que o mesmo processo de construção crie diferentes representações.
( ) Este padrão permite que uma família de algoritmos seja definida e encapsulada em classes separadas, permitindo que os algoritmos possam ser trocados de forma intercambiável.
( ) Este padrão oferece uma interface unificada para um conjunto de interfaces em um subsistema. Ele define uma interface de nível mais alto que torna o subsistema mais fácil de usar.
( ) Este padrão define uma dependência um-para-muitos entre objetos, na qual, quando um objeto muda de estado, todos os seus dependentes são notificados e atualizados automaticamente.
Acerca do fluxo de Big Data, julgue o item que se segue.
Na etapa de captura de Big Data, grandes volumes de dados
são armazenados em bancos de dados NoSQL, devido à sua
escalabilidade e à sua flexibilidade.
Acerca do fluxo de Big Data, julgue o item que se segue.
As funções do MapReduce transformam um volume grande
de dados em grupamentos segmentados, mantendo na saída
a mesma quantidade de dados da entrada.
Acerca do fluxo de Big Data, julgue o item que se segue.
O serviço ElasticSearch utiliza índices divididos em
fragmentos, de maneira que cada nó armazena diversos
fragmentos e atua na coordenação das operações nos vários
fragmentos.
Acerca do fluxo de Big Data, julgue o item que se segue.
Streaming processing é uma tecnologia de Big Data
exclusiva para atender processamentos de serviços de
streaming de áudio e vídeo.
Acerca do fluxo de Big Data, julgue o item que se segue.
Na apresentação de dados, a extração de subcoleções e a
consulta de parâmetros permitem a navegação em diversos
cenários da visualização.
A respeito de Big Data, julgue o próximo item.
No processamento ROLAP, bancos de dados relacionais são
utilizados como local de armazenamento para agregação,
enquanto, nos processamentos MOLAP e HOLAP,
utilizam-se bancos de dados multidimensionais.
A respeito de Big Data, julgue o próximo item.
O processo de ELT, devido às suas etapas, exige maior definição
de regras, estruturas e relações do que a abordagem ETL.
A respeito de Big Data, julgue o próximo item.
Subconjunto de um data warehouse, o data mart é
especializado em uma área específica de uma organização.
A respeito de Big Data, julgue o próximo item.
Em um data lake, os dados são depositados em estado bruto,
sem terem passado por qualquer análise e mesmo sem terem
uma governança.
A respeito de Big Data, julgue o próximo item.
Projetos de Big Data, quando necessário, crescem
horizontalmente, com a inclusão de novos nodos, e
verticalmente, com o acréscimo de mais memória.
A respeito de Big Data, julgue o próximo item.
No modelo SaaS (software as a service) da computação em
nuvem utilizado para Big Data, a aplicação e os dados são
gerenciados pelo provedor da nuvem.
A respeito de Big Data, julgue o próximo item.
O YARN (Yet Another Resource Negotiator) é um sistema
de arquivos distribuídos que faz parte do framework Hadoop.
A respeito de Big Data, julgue o próximo item.
A coleta de dados por meio de aplicativos é considerada
explícita, porque o usuário a autoriza.
A respeito de Big Data, julgue o próximo item.
Em Big Data, ruídos consistem em informações extras que
acabam deturpando as análises, enquanto overfitting designa
a interpretação equivocada dos ruídos como dados legítimos.
A respeito de Big Data, julgue o próximo item.
Pipelines de dados apresentam uma única estrutura para o
recebimento dos dados originados de uma fonte não
confiável.
A respeito de técnicas de redução de dimensionalidade, julgue o item subsecutivo.
Para utilizar de forma adequada a análise de componentes
principais (PCA, na sigla em inglês), é essencial normalizar
os dados; se as variáveis não estiverem na mesma escala,
aquelas com maior variância terão maior impacto,
distorcendo o resultado da PCA.
Em relação ao tratamento e à qualidade dos dados no sistema de gerenciamento de informações, julgue o item subsequente.
O agente de tratamento deve demonstrar a adoção de
medidas eficazes e capazes de comprovar a observância e o
cumprimento das normas de proteção de dados pessoais,
bem como demonstrar a eficácia dessas medidas.

 Conheça nossos planos