Questões de Concurso
Comentadas sobre modelo relacional em banco de dados
Foram encontradas 586 questões


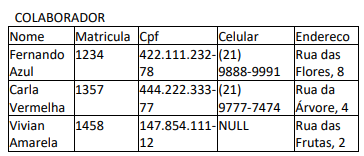
Na relação COLABORADOR, o(a):
Observe o Modelo de Entidades e Relacionamentos a seguir.
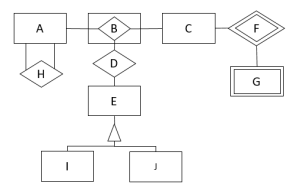
Com base nos relacionamentos apresentados, está explícito que:
No que diz respeito ao modelo entidade‑relacionamento (ER), ao Data Lake e à discretização, julgue o próximo item.
No Modelo ER, uma entidade fraca é representada por
um triângulo.
No que se refere à representação de dados numéricos e aos conceitos de bancos de dados relacionais, julgue o item seguinte.
Caso conste, no modelo de dados referente ao cadastro de
empregados de determinada empresa, o atributo idade do
empregado, não é necessário que esse dado esteja
fisicamente armazenado no banco de dados, uma vez que ele
pode ser calculado com a data de nascimento em tempo de
execução, o que caracteriza um atributo do tipo derivado.
FUNCIONÁRIOS (idFunc; idAtividade; Nome; DescricaoAtiv; Data; Tempo), na qual tanto idFunc quanto idAtividade são utilizadas como chave primária.
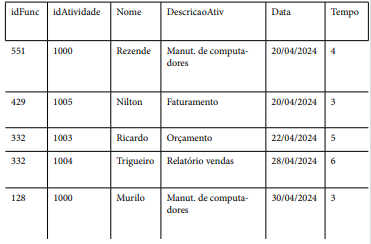
Levando-se em conta a definição da primeira, segunda e terceira formas normais, a tabela acima NÃO se encontra na
A respeito de banco de dados, julgue o item que se segue.
Em uma consulta a duas tabelas, o produto cartesiano
ocorrerá quando a condição de união estiver corretamente
especificada.
Produto (ID, Nome, Tipo, Preço, Fabricante)
Assinale a alternativa que corresponde à consulta que retornará o nome e o preço dos produtos que possuem a palavra “Smart” em seu tipo, somente do fabricante “Banana Inc.” e preço abaixo de R$2000,00.
LOCALIDADE ( id_loc , nome_localidade, cidade, estado )
COORDENADOR ( id_coord , nome_coord, id_loc )
Restrições de integridade:
Tabela LOCALIDADE: id_loc é chave primária; nome_localidade ≠ NULO; cidade ≠ NULO; estado = {‘PR’ ou ‘SC’ ou ‘RS’}.
Tabela COORDENADOR: id_coord é chave primária; nome_coord ≠ NULO; id_loc é chave estrangeira e referencia LOCALIDADE(id_loc).
A equipe que administra o banco de dados em tela decidiu convertê-lo de uma versão centralizada para uma distribuída. Para isso, decidiu que a divisão dos dados será guiada pelo critério do estado ao qual a localidade pertence. Ou seja, após distribuir os registros de localidade por fragmentos, os dados da tabela COORDENADOR serão distribuídos em função do critério de localidade apresentado.
No que concerne à divisão a ser realizada na tabela COORDENADOR, a fragmentação de suas tuplas (linhas) dever ser classificada como
Considere o esquema relacional a seguir, implementado em SQL.

select r.nome from recurso r left join alocacao a on a.id_recurso=r.id where a.id_projeto is null
apresenta o nome dos recursos
A Análise e Projeto de software são etapas críticas no desenvolvimento de sistemas de software bem-sucedidos. Eles fornecem a base para a implementação eficaz de soluções que atendam às necessidades dos usuários finais, minimizem riscos, reduzam custos e melhorem a qualidade do produto final.
Disponível em: https://www.computer.org/. Acesso em: 20 fev. 2024.
Na Análise e Projeto de Software, é uma técnica de modelagem de dados relacional o:
create table X1(
A1 int not null primary key,
B1 int)
create table X2(
A2 int not null primary key,
B2 int)
create table X3(
A1 int not null unique,
A2 int,
B3 int,
foreign key(A1) references X1(A1),
foreign key(A2) references X2(A2)
)
Para o esquema apresentado, a relação que existe entre as tabelas X1, X2 e X3 é descrita por:
O índice mais utilizado, e usualmente adotado por default em gerenciadores de bancos de dados relacionais, é conhecido genericamente como:

 Conheça nossos planos