Questões de Concurso
Comentadas sobre banco de dados em banco de dados
Foram encontradas 1.325 questões


Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 9 - TI / Infraestrutura e Segurança - Tarde |
Q2518849
Banco de Dados
Lara trabalha em uma empresa aérea e todos os dias, às 17:00, é
gerado por ela um relatório com o número total de reservas em
todos os voos de sua companhia. Porém, ao apresentar o
relatório ao seu encarregado, ela vem notando que o número
total tem mostrado inconsistências. O relatório calculava
incorretamente a quantidade de reservas, pois pegava alguns
dados de antes do cálculo do número total e outros de depois
desse cálculo.
Lara pesquisou o problema na transação e o identificou como:
Lara pesquisou o problema na transação e o identificou como:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 9 - TI / Infraestrutura e Segurança - Tarde |
Q2518848
Banco de Dados
João trabalha na filial de uma multinacional no Rio de Janeiro
(GMT-3) e recebeu alguns relatórios da sede da empresa
localizada na Califórnia (GMT-8). Durante a verificação, João
identificou uma tabela com uma coluna que trazia informações
de timestamp e timezone da sua filial e não da sede onde o
relatório havia sido gerado. João entrou em contato com a sede
para relatar o ocorrido, pois, se o relatório foi feito na Califórnia,
deveria estar com as configurações de timestamp e timezone da
sede. Entretanto, a sede da empresa informou que tabela
anexada ao relatório teve seu campo definido como:
Ano: 2024
Banca:
FGV
Órgão:
INPE
Prova:
FGV - 2024 - INPE - Tecnologista Pleno I - Desenvolvimento ou Aprimoramento de Sistema de Assimilação de Dados nas Componentes do Sistema Terrestre e de Aplicações para Monitoramento do Processo de Assimilação |
Q2518316
Banco de Dados
Considere a lista de processos computacionais abaixo.
1. Integração do modelo não-linear para frente no tempo.
2. Integração do modelo não-linear para trás no tempo.
3. Integração do modelo adjunto para frente no tempo.
4. Integração do modelo adjunto para trás no tempo.
5. Integração do modelo tangente linear no loop interno.
6. Integração do modelo tangente linear no loop externo.
Assinale a opção que apresenta os processos realizados em assimilação de dados 4DVAR incremental, com restrição forte, na sequência correta de execução.
1. Integração do modelo não-linear para frente no tempo.
2. Integração do modelo não-linear para trás no tempo.
3. Integração do modelo adjunto para frente no tempo.
4. Integração do modelo adjunto para trás no tempo.
5. Integração do modelo tangente linear no loop interno.
6. Integração do modelo tangente linear no loop externo.
Assinale a opção que apresenta os processos realizados em assimilação de dados 4DVAR incremental, com restrição forte, na sequência correta de execução.
Ano: 2024
Banca:
FGV
Órgão:
INPE
Prova:
FGV - 2024 - INPE - Tecnologista Pleno I - Desenvolvimento ou Aprimoramento de Sistema de Assimilação de Dados nas Componentes do Sistema Terrestre e de Aplicações para Monitoramento do Processo de Assimilação |
Q2518311
Banco de Dados
A integração de técnicas de inteligência artificial e aprendizado de
máquina com assimilação de dados pode aumentar a confiabilidade
das previsões por introduzir modelos orientados a dados obtidos por
meio de observações. A performance dos modelos de aprendizado
de máquina pode ser medida por algumas métricas, como por
exemplo a métrica Mean Absolute Error (MAE).
Considere um modelo de regressão usado para prever valores de uma variável, conforme a tabela a seguir.
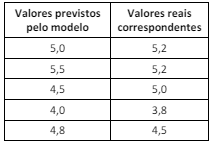
O MAE para o conjunto de dados representado na tabela será
Considere um modelo de regressão usado para prever valores de uma variável, conforme a tabela a seguir.
O MAE para o conjunto de dados representado na tabela será
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517658
Banco de Dados
As demandas de dados pelos analistas e cientistas de dados da
CVM estão aumentando a cada dia. Para atendê-las com
agilidade, é necessário obter dados de diversas fontes
heterogêneas no seu formato original para posterior seleção e
processamento sob demanda.
Para armazenar dados estruturados, não estruturados e semiestruturados, deve-se implementar um(a):
Para armazenar dados estruturados, não estruturados e semiestruturados, deve-se implementar um(a):
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517657
Banco de Dados
O dado no formato JSON – padrão utilizado para armazenar e
transportar dados – deve ser de algum tipo.
O dado que representa o tipo de dado JSON Array é o:
O dado que representa o tipo de dado JSON Array é o:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517653
Banco de Dados
O analista Gabriel fez um levantamento das bases de dados
existentes na CVM e percebeu que havia Data Marts distintos,
criados para atender a requisitos analíticos específicos de cada
Superintendência, como: Relações Institucionais, Auditoria e
Registro de Valores Imobiliários. Cada Data Mart foi construído
de forma independente, o que dificultava análises integradas
para relacionar dados das diferentes Superintendências. Gabriel
observou que havia várias dimensões em comum nos Data Marts.
Para permitir análises integradas padronizando e compartilhando
as dimensões em comum dos Data Marts da CVM, Gabriel
implementou um(a):
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517646
Banco de Dados
Documentos do Jupyter Notebook são salvos com a extensão
.ipynb, mas internamente eles são documentos do tipo:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517641
Banco de Dados
Uma certa organização gostaria de compartilhar dados com um
grupo de pesquisadores de uma universidade para a condução de
um estudo sobre problemas ergonômicos nos seus escritórios.
Entre os dados coletados, há informações sensíveis sobre seus
funcionários; portanto, o responsável pela coleta decidiu
anonimizar os dados. Isso foi feito removendo-se nomes e outros
campos identificadores e adicionando-se um número
identificador próprio a cada funcionário. Dessa forma, a
identidade dos funcionários seria preservada. Após a verificação
de uma amostra, o pesquisador responsável pelo estudo
recomendou medidas que deveriam ser aplicadas antes que os
dados pudessem ser aceitos para o estudo.
O problema que mais provavelmente motivou a recomendação do pesquisador e uma medida que pode mitigar esse problema são, respectivamente:
O problema que mais provavelmente motivou a recomendação do pesquisador e uma medida que pode mitigar esse problema são, respectivamente:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517637
Banco de Dados
Ao receber um conjunto de dados para elaborar um modelo
preditivo, uma equipe de analistas de dados percebeu que havia
uma quantidade significativa de dados faltantes em certos
atributos. Foi então debatido o uso de duas técnicas para lidar
com esse problema: (1) remoção de observações contendo dados
ausentes e (2) “inputação” multivariável, sendo que apenas uma
das duas seria aplicada.
Duas características do conjunto de dados que devem ser prioritariamente consideradas na escolha entre as duas técnicas são:
Duas características do conjunto de dados que devem ser prioritariamente consideradas na escolha entre as duas técnicas são:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517636
Banco de Dados
Para ser utilizado em um modelo neural de regressão, um
conjunto de dados precisa ser tratado de tal forma que todos os
atributos de entrada sejam representados como um ou mais
valores numéricos no intervalo [0, 1].
Os atributos de uma observação são: idade (inteiro >= 18), escolaridade (fundamental, médio, superior, pós-graduação), estado de residência (Acre, Alagoas, …, Tocantins, incluindo Distrito Federal) e local de trabalho (empresa, home office, misto).
O número mínimo de valores necessários para representar uma observação com os atributos acima descritos para o modelo de regressão, de forma que não ocorra perda de informação ordinal nem inserção de vieses nos dados, é:
Os atributos de uma observação são: idade (inteiro >= 18), escolaridade (fundamental, médio, superior, pós-graduação), estado de residência (Acre, Alagoas, …, Tocantins, incluindo Distrito Federal) e local de trabalho (empresa, home office, misto).
O número mínimo de valores necessários para representar uma observação com os atributos acima descritos para o modelo de regressão, de forma que não ocorra perda de informação ordinal nem inserção de vieses nos dados, é:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517635
Banco de Dados
Visando a maximizar a eficiência de uma equipe de auditores
fiscais, um sistema de classificação de documentação foi
encomendado à equipe de ciência de dados, com o objetivo de
decidir, com base nos documentos obtidos durante uma
fiscalização, se um exame detalhado de documentação é ou não
necessário.
Idealmente, o sistema permitiria aos auditores direcionar mais tempo às auditorias complexas e agilizar a análise dos casos mais simples, otimizando o custo de pessoal e equipamento especializado. Contudo, não examinar detalhadamente um caso complexo pode custar muito caro ao governo, a ponto de anular quaisquer ganhos obtidos usando o sistema com um pequeno número de erros.
Considerando esse cenário, e o fato de o sistema de classificação responder apenas “sim” ou “não” quanto à necessidade de exame detalhado, a métrica de classificação a ser maximizada pela equipe que irá implementar o sistema é:
Idealmente, o sistema permitiria aos auditores direcionar mais tempo às auditorias complexas e agilizar a análise dos casos mais simples, otimizando o custo de pessoal e equipamento especializado. Contudo, não examinar detalhadamente um caso complexo pode custar muito caro ao governo, a ponto de anular quaisquer ganhos obtidos usando o sistema com um pequeno número de erros.
Considerando esse cenário, e o fato de o sistema de classificação responder apenas “sim” ou “não” quanto à necessidade de exame detalhado, a métrica de classificação a ser maximizada pela equipe que irá implementar o sistema é:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517634
Banco de Dados
Uma equipe de analistas de dados preparou um modelo preditivo
cuja entrada consiste em planilhas contendo uma matriz de
valores reais entre 1 e 10. Tais planilhas são obtidas de um
sistema externo à equipe. O modelo foi treinado com um
conjunto de planilhas que foi coletado pelos analistas, de forma a
obter uma amostra representativa dos dados a serem utilizados.
A média e o desvio padrão de duas colunas importantes foram
calculados do conjunto de treinamento, como uma forma simples
de verificar a consistência da distribuição dos dados, sendo seus
valores 4,89 e 3,08, respectivamente. O modelo obteve bons
resultados durante sua etapa de testes, com uma precisão de
94%.
Ao iniciar a operação do modelo com planilhas atuais, entretanto, os analistas observaram que o modelo teve um desempenho muito inferior, com precisão de apenas 72%. Investigando as planilhas recebidas, obtiveram a média e o desvio padrão para as duas colunas importantes com valores 5,34 e 3,68, respectivamente.
A explicação mais adequada à situação descrita é:
Ao iniciar a operação do modelo com planilhas atuais, entretanto, os analistas observaram que o modelo teve um desempenho muito inferior, com precisão de apenas 72%. Investigando as planilhas recebidas, obtiveram a média e o desvio padrão para as duas colunas importantes com valores 5,34 e 3,68, respectivamente.
A explicação mais adequada à situação descrita é:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517632
Banco de Dados
Flávia, responsável pelo setor de análise de dados de uma rede
de concessionárias de carros, está realizando o pré-processamento dos dados dos clientes da rede. Entre os atributos
do conjunto de dados, estão os CPFs dos clientes, o seu sexo e a
quantidade de carros que eles já compraram na rede.
Esses três atributos podem ser classificados, respectivamente, como:
Esses três atributos podem ser classificados, respectivamente, como:
Ano: 2024
Banca:
FGV
Órgão:
CVM
Prova:
FGV - 2024 - CVM - Analista CVM - Perfil 7 - Ciência de Dados - Tarde |
Q2517623
Banco de Dados
Observe os conjuntos de dados a seguir.
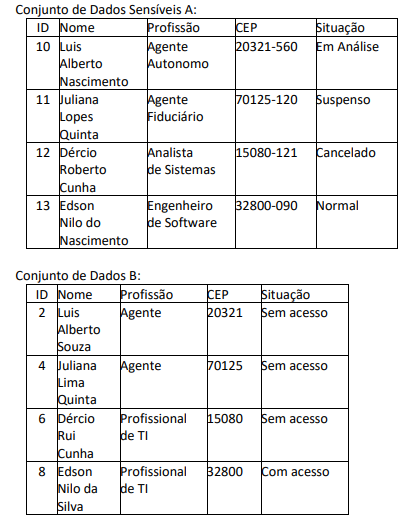
Para desidentificar o Conjunto de Dados Sensíveis A e gerar o
Conjunto de Dados B, a técnica de anonimização que deve ser
aplicada é o(a):
Ano: 2024
Banca:
FGV
Órgão:
INPE
Prova:
FGV - 2024 - INPE - Tecnologista Pleno I - Processamento de Dados Meteorológicos e Georreferenciados; Desenvolvimento de Software na Área de Meteorologia |
Q2514691
Banco de Dados
Sobre os formatos NetCDF4 e HDF5, no contexto de armazenamento
e processamento de dados científicos, assinale a afirmativa correta.
Ano: 2024
Banca:
FGV
Órgão:
INPE
Prova:
FGV - 2024 - INPE - Tecnologista Pleno I - Processamento de Dados Meteorológicos e Georreferenciados; Desenvolvimento de Software na Área de Meteorologia |
Q2514689
Banco de Dados
Sobre dados no formato NetCDF4, assinale a afirmativa incorreta.
Ano: 2024
Banca:
FGV
Órgão:
INPE
Prova:
FGV - 2024 - INPE - Tecnologista Pleno I - Processamento de Dados Meteorológicos e Georreferenciados; Desenvolvimento de Software na Área de Meteorologia |
Q2514667
Banco de Dados
Em relação a uma função do tipo janela (Window Functions), analise
as afirmativas a seguir e assinale (V) para a verdadeira e (F) para a
falsa.
( ) Cria uma tabela não materializada no banco de dados, de forma que suas consultas são executadas todas as vezes em que a tabela é referenciada.
( ) Permite realizar cálculos utilizando um conjunto de linhas que possuem alguma relação com a linha em questão.
( ) É comparável ao tipo de cálculos realizados por funções de agregação
As afirmativas são, respectivamente,
( ) Cria uma tabela não materializada no banco de dados, de forma que suas consultas são executadas todas as vezes em que a tabela é referenciada.
( ) Permite realizar cálculos utilizando um conjunto de linhas que possuem alguma relação com a linha em questão.
( ) É comparável ao tipo de cálculos realizados por funções de agregação
As afirmativas são, respectivamente,
Ano: 2024
Banca:
Quadrix
Órgão:
IBICT
Prova:
Quadrix - 2024 - IBICT - Tecnologista - Tecnologia da Informação |
Q2509353
Banco de Dados
Quanto aos processos de ETL, ao JSON, ao XML e às técnicas para pré‑processamento de dados, julgue o item.
A imputação por moda é uma técnica comumente utilizada no pré‑processamento de dados, para se lidar com valores ausentes.
A imputação por moda é uma técnica comumente utilizada no pré‑processamento de dados, para se lidar com valores ausentes.
Ano: 2024
Banca:
Quadrix
Órgão:
IBICT
Prova:
Quadrix - 2024 - IBICT - Tecnologista - Tecnologia da Informação |
Q2509351
Banco de Dados
Quanto aos processos de ETL, ao JSON, ao XML e às técnicas para pré‑processamento de dados, julgue o item.
JSON pode ser definido como um formato leve de troca de informações/dados entre sistemas.
JSON pode ser definido como um formato leve de troca de informações/dados entre sistemas.

 Conheça nossos planos